# Audio Spectrogram Transformer
## 개요
Audio Spectrogram Transformer 모델은 Yuan Gong, Yu-An Chung, James Glass가 [AST: Audio Spectrogram Transformer](https://huggingface.co/papers/2104.01778)에서 제안했습니다. Audio Spectrogram Transformer는 오디오를 이미지(스펙트로그램)로 변환하여 [Vision Transformer](vit)를 오디오에 적용합니다. 이 모델은 오디오 분류에서 최첨단(SOTA) 결과를 달성합니다.
해당 논문의 초록은 다음과 같습니다:
*지난 10년간, 합성 신경망(CNN)은 오디오 스펙트로그램에서 해당 라벨로의 직접적인 매핑을 학습하는 것을 목표로 하는 엔드투엔드 오디오 분류 모델의 주요 구성 요소로 널리 채택되었습니다. 긴 범위의 전역 컨텍스트를 더 잘 포착하기 위해, 최근에는 CNN 위에 셀프 어텐션 메커니즘을 추가하여 CNN-어텐션 하이브리드 모델을 구성하는 추세가 있습니다. 그러나 CNN에 대한 의존성이 반드시 필요한지, 그리고 순수하게 어텐션 기반인 신경망만으로도 오디오 분류에서 좋은 성능을 얻을 수 있는지는 명확하지 않습니다. 본 논문에서는 오디오 스펙트로그램 트랜스포머(AST)를 소개하여 이 질문에 답합니다. AST는 오디오 분류를 위한 첫 번째 합성 없는, 순수 어텐션 기반 모델입니다. AST를 다양한 오디오 분류 벤치마크에서 평가한 결과, AudioSet에서 0.485 mAP, ESC-50에서 95.6% 정확도, Speech Commands V2에서 98.1% 정확도라는 새로운 최첨단(SOTA) 결과를 달성했습니다.*
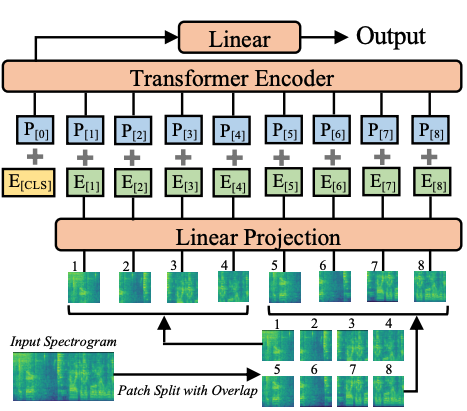 Audio Spectrogram Transformer 아키텍처. 원 논문에서 가져온 것입니다.
이 모델은 [nielsr](https://huggingface.co/nielsr)에 의해 기여되었습니다. 원본 코드는 [여기](https://github.com/YuanGongND/ast)에서 찾을 수 있습니다.
## 사용 팁
- Audio Spectrogram Transformer (AST)를 자체 데이터셋으로 fine-tuning할 때는 입력 정규화(input normalization)를 직접 처리하는 것이 권장됩니다(
입력의 평균이 0이고 표준편차가 0.5인지 확인하십시오). [ASTFeatureExtractor](/docs/transformers/main/ko/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor)가 이를 처리합니다. 기본적으로 AudioSet의 평균과 표준편차를 사용한다는 점에 유의하십시오. 저자들이 다운스트림 데이터셋에 대한 통계를 어떻게 계산하는지 확인하려면 [`ast/src/get_norm_stats.py`](https://github.com/YuanGongND/ast/blob/master/src/get_norm_stats.py)를 참조하십시오.
- AST는 낮은 학습률이 필요하다는 점에 유의하세요(저자들은 10배 더 작은 학습률을 사용하며, 이는 CNN 모델과 비교할 때입니다).
[PSLA 논문](https://huggingface.co/papers/2102.01243))에서 빠르게 수렴하므로, 해당 작업에 적합한 learning rate와 learning rate scheduler를 찾아보시기 바랍니다.
### Scaled Dot Product Attention(SDPA) 사용
PyTorch에는 `torch.nn.functional`의 일부로 네이티브 scaled dot-product attention(SDPA) 연산자가 포함되어 있습니다. 이 함수는 입력과 사용 중인 하드웨어에 따라 적용할 수 있는 여러 구현을 포함합니다. 자세한 내용은 [공식 문서](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html) 또는 [GPU Inference](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention) 페이지를 참고하세요.
구현이 사용 가능한 경우 `torch>=2.1.1`에서는 기본적으로 SDPA가 사용되지만, `from_pretrained()`에서 `attn_implementation="sdpa"`를 설정하여 SDPA 사용을 명시적으로 요청할 수도 있습니다.
```python
from transformers import ASTForAudioClassification
model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593", attn_implementation="sdpa", device_map="auto")
...
```
최고의 속도 향상을 위해 모델은 반정밀(half-precision, 예: `torch.float16` 또는 `torch.bfloat16`)로 로드하는 것을 권장합니다.
로컬 벤치마크(A100-40GB, PyTorch 2.3.0, OS Ubuntu 22.04)에서 `float32`와 `MIT/ast-finetuned-audioset-10-10-0.4593` 모델을 사용하여 추론 시 다음과 같은 속도 향상을 확인했습니다.
| 배치 크기 | 평균 추론 시간(ms), eager 모드 | 평균 추론 시간(ms), sdpa 모델 | 속도 향상, Sdpa / Eager (x) |
|--------------|-------------------------------------------|-------------------------------------------|------------------------------|
| 1 | 27 | 6 | 4.5 |
| 2 | 12 | 6 | 2 |
| 4 | 21 | 8 | 2.62 |
| 8 | 40 | 14 | 2.86 |
## 리소스
Audio Spectrogram Transformer를 시작하는 데 도움이 되는 공식 Hugging Face 및 커뮤니티(🌎로 표시) 리소스 목록입니다.
- 음성 분류를 위한 AST 추론을 보여주는 노트북은 [여기](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/AST)에서 찾을 수 있습니다.
- [ASTForAudioClassification](/docs/transformers/main/ko/model_doc/audio-spectrogram-transformer#transformers.ASTForAudioClassification)은 이 [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/audio_classification.ipynb)에서 지원됩니다.
- 참고: [오디오 분류](../tasks/audio_classification).
여기에 포함할 리소스를 제출하고 싶으시면 Pull Request를 열어 주시면 검토하겠습니다! 기존 리소스와 중복되지 않고 새로운 것을 보여주는 것이 이상적입니다.
## ASTConfig[[transformers.ASTConfig]]
#### transformers.ASTConfig[[transformers.ASTConfig]]
```python
transformers.ASTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, patch_size: int | list[int] | tuple[int, int] = 16, qkv_bias: bool = True, frequency_stride: int = 10, time_stride: int = 10, max_length: int = 1024, num_mel_bins: int = 128)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/configuration_audio_spectrogram_transformer.py#L24)
**매개변수:**
hidden_size (`int`, *선택 사항*, 기본값 `768`) : 숨겨진 표현의 차원.
num_hidden_layers (`int`, *선택 사항*, 기본값 `12`) : Transformer decoder의 숨겨진 레이어 수입니다.
num_attention_heads (`int`, *선택 사항*, 기본값 `12`) : Transformer decoder의 각 attention layer에 사용되는 attention head의 수입니다.
intermediate_size (`int`, *선택 사항*, 기본값 `3072`) : MLP 표현의 차원.
hidden_act (`str`, *선택 사항*, 기본값 `gelu`) : 디코더에서 사용되는 비선형 활성화 함수(함수 또는 문자열). 예를 들어, `"gelu"`, `"relu"`, `"silu"` 등이 있습니다.
hidden_dropout_prob (`Union[float, int]`, *선택 사항*, 기본값 `0.0`) : 임베딩, 인코더, 풀러의 모든 완전 연결 계층에 적용되는 dropout 확률입니다.
attention_probs_dropout_prob (`Union[float, int]`, *선택 사항*, 기본값 `0.0`) : attention 확률에 적용할 dropout 비율입니다.
initializer_range (`float`, *선택 사항*, 기본값 `0.02`) : 모든 가중치 행렬을 초기화하는 truncated_normal_initializer의 표준 편차입니다.
layer_norm_eps (`float`, *선택 사항*, 기본값 `1e-12`) : layer normalization 레이어에서 사용되는 epsilon 값입니다.
patch_size (`Union[int, list[int], tuple[int, int]]`, *선택*, 기본값 `16`) : 각 패치의 크기(해상도).
qkv_bias (`bool`, *선택 사항*, 기본값 `True`) : 쿼리, 키, 값에 bias를 추가할지 여부.
frequency_stride (`int`, *선택 사항*, 기본값 10) : 스펙트로그램을 패치화할 때 사용할 주파수 스트라이드입니다.
time_stride (`int`, *선택 사항*, 기본값 10) : 스펙트로그램을 패치화할 때 사용할 시간 스트라이드입니다.
max_length (`int`, *선택 사항*, 기본값 1024) : 스펙트로그램의 시간 차원입니다.
num_mel_bins (`int`, *선택 사항*, 기본값 `128`) : 입력 프레임당 사용되는 mel 특징의 수입니다. `AutoFeatureExtractor` 클래스에서 사용된 값과 일치해야 합니다.
이것은 Audio Spectrogram Transformer 모델의 설정을 저장하기 위한 설정 클래스입니다. 지정된 인자에 따라 Audio Spectrogram Transformer 모델을 인스턴스화하고 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 설정을 인스턴스화하면 [MIT/ast-finetuned-audioset-10-10-0.4593](https://huggingface.co/MIT/ast-finetuned-audioset-10-10-0.4593)의 설정과 유사한 설정이 생성됩니다.
Configuration 객체는 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)를 상속하며, 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)의 문서를 참고하세요.
예:
```python
>>> from transformers import ASTConfig, ASTModel
>>> # Initializing a AST MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> configuration = ASTConfig()
>>> # Initializing a model (with random weights) from the MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> model = ASTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ASTFeatureExtractor[[transformers.ASTFeatureExtractor]]
#### transformers.ASTFeatureExtractor[[transformers.ASTFeatureExtractor]]
```python
transformers.ASTFeatureExtractor(feature_size = 1, sampling_rate = 16000, num_mel_bins = 128, max_length = 1024, padding_value = 0.0, do_normalize = True, mean = -4.2677393, std = 4.5689974, return_attention_mask = False, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/feature_extraction_audio_spectrogram_transformer.py#L38)
**매개변수:**
feature_size (`int`, *선택 사항*, 기본값 1) : 추출된 특징(feature)의 차원입니다.
sampling_rate (`int`, *선택 사항*, 기본값 16000) : 오디오 파일을 디지털화할 때 사용할 샘플링 주파수입니다. 헤르츠(Hz) 단위로 표시됩니다.
num_mel_bins (`int`, *선택 사항*, 기본값 128) : Mel 주파수 바인 수.
max_length (`int`, *선택 사항*, 기본값 1024) : 추출된 특징을 패딩/잘라낼 최대 길이입니다.
do_normalize (`bool`, *선택 사항*, 기본값 `True`) : `mean`과 `std`를 사용하여 log-Mel 특징을 정규화할지 여부.
mean (`float`, *선택 사항*, 기본값 -4.2677393) : log-Mel 특징을 정규화하는 데 사용되는 평균 값입니다. 기본적으로 AudioSet 평균을 사용합니다.
std (`float`, *선택 사항*, 기본값 4.5689974) : log-Mel 특징을 정규화하는 데 사용되는 표준 편차 값입니다. 기본적으로 AudioSet 표준 편차를 사용합니다.
return_attention_mask (`bool`, *선택 사항*, 기본값 `False`) : [__call__()](/docs/transformers/main/ko/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__)에서 `attention_mask`를 반환할지 여부.
Audio Spectrogram Transformer(AST) feature extractor를 생성합니다.
이 feature extractor는 대부분의 주요 메서드를 포함하는 [SequenceFeatureExtractor](/docs/transformers/main/ko/main_classes/feature_extractor#transformers.SequenceFeatureExtractor)를 상속합니다. 해당 메서드에 대한 자세한 내용은 이 상위 클래스를 참고하세요.
이 클래스는 설치된 경우 TorchAudio를, 그렇지 않은 경우 numpy를 사용하여 원시 음성에서 mel-filter bank features를 추출하고, 고정 길이에 맞게 패딩/잘라낸 뒤 평균과 표준편차로 정규화합니다.
#### __call__[[transformers.ASTFeatureExtractor.__call__]]
```python
__call__(raw_speech: numpy.ndarray | list[float] | list[numpy.ndarray] | list[list[float]], sampling_rate: int | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/feature_extraction_audio_spectrogram_transformer.py#L160)
**매개변수:**
raw_speech (`np.ndarray`, `list[float]`, `list[np.ndarray]`, `list[list[float]]`) : 패딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 numpy 배열, float 값의 리스트, numpy 배열의 리스트, float 값의 리스트의 리스트일 수 있습니다. 스테레오가 아닌 모노 채널 오디오여야 하며, 즉 각 타임스텝당 float 값이 하나만 있어야 합니다.
sampling_rate (`int`, *선택 사항*) : `raw_speech` 입력이 샘플링된 샘플링 레이트입니다. 조용한 오류를 방지하기 위해 forward 호출 시 `sampling_rate`를 전달하는 것이 강력히 권장됩니다.
return_tensors (`str` 또는 [TensorType](/docs/transformers/main/ko/internal/file_utils#transformers.TensorType), *optional*) : 설정된 경우, python 정수 목록 대신 텐서를 반환합니다. 허용되는 값은 다음과 같습니다: - `'pt'`: PyTorch `torch.Tensor` 객체를 반환합니다. - `'np'`: Numpy `np.ndarray` 객체를 반환합니다.
하나 이상의 시퀀스를 특징화(featurize)하고 모델에 맞게 준비하는 주요 메서드입니다.
## ASTModel[[transformers.ASTModel]]
#### transformers.ASTModel[[transformers.ASTModel]]
```python
transformers.ASTModel(config: ASTConfig)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L257)
**매개변수:**
config ([ASTConfig](/docs/transformers/main/ko/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하면 모델에 연결된 가중치가 로드되지 않고 구성만 로드됩니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
특정 헤드가 위에 없는 상태에서 원시 hidden-states를 출력하는 기본 Audio Spectrogram Transformer Model입니다.
이 모델은 [PreTrainedModel](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.ASTModel.forward]]
```python
forward(input_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L273)
**매개변수:**
input_values (`torch.Tensor`, shape `(batch_size, max_length, num_mel_bins)`) : 원시 오디오 웨이브폼에서 추출한 Float 값의 mel 특징입니다. 원시 오디오 웨이브폼은 `.flac` 또는 `.wav` 오디오 파일을 `list[float]` 타입의 배열, `numpy.ndarray` 또는 `torch.Tensor`로 로드하여 얻을 수 있으며, *예를 들어* torchcodec 라이브러리(`pip install torchcodec`)나 soundfile 라이브러리(`pip install soundfile`)를 통해 가능합니다. `input_features`로 배열을 준비하려면, mel 특징 추출, 패딩, `torch.Tensor` 타입의 텐서 변환을 위해 [AutoFeatureExtractor](/docs/transformers/main/ko/model_doc/auto#transformers.AutoFeatureExtractor)를 사용해야 합니다. [__call__()](/docs/transformers/main/ko/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__)를 참조하세요.
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
**반환값:** [BaseModelOutputWithPooling](/docs/transformers/main/ko/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 또는 `tuple(torch.Tensor)`
[ASTConfig](/docs/transformers/main/ko/model_doc/audio-spectrogram-transformer#transformers.ASTConfig) 및 입력에 따라 다양한 요소를 포함하는 [BaseModelOutputWithPooling](/docs/transformers/main/ko/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되었거나 `config.return_dict=False`인 경우).
[ASTModel](/docs/transformers/main/ko/model_doc/audio-spectrogram-transformer#transformers.ASTModel)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **last_hidden_state** (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`) -- 모델의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.
- **pooler_output** (`torch.Tensor`, shape `(batch_size, hidden_size)`) -- 시퀀스의 첫 번째 토큰(분류 토큰)의 마지막 레이어 hidden-state입니다. 보조 사전학습 작업을 위해 사용되는 레이어들을 통해 추가 처리된 값입니다. 예를 들어 BERT 계열 모델의 경우, 선형 레이어와 tanh 활성화 함수를 통해 처리된 분류 토큰을 반환합니다. 선형 레이어의 가중치는 사전학습 단계에서 다음 문장 예측(분류) 목적 함수를 통해 학습됩니다.
- **hidden_states** (`tuple(torch.Tensor)`, *선택 사항*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력 1개 + 각 레이어의 출력 1개)로, 형태는 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple(torch.Tensor)`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
## ASTForAudioClassification[[transformers.ASTForAudioClassification]]
#### transformers.ASTForAudioClassification[[transformers.ASTForAudioClassification]]
```python
transformers.ASTForAudioClassification(config: ASTConfig)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L327)
**매개변수:**
config ([ASTConfig](/docs/transformers/main/ko/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하면 모델에 연결된 가중치가 로드되지 않고 구성만 로드됩니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
AudioSet, Speech Commands v2와 같은 데이터셋을 위해, 풀링된 출력 위에 선형 레이어를 배치한 오디오 분류 헤드를 갖춘 Audio Spectrogram Transformer 모델
이 모델은 [PreTrainedModel](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.ASTForAudioClassification.forward]]
```python
forward(input_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L340)
**매개변수:**
input_values (`torch.Tensor`, shape `(batch_size, max_length, num_mel_bins)`) : 원시 오디오 웨이브폼에서 추출한 Float 값의 mel 특징입니다. 원시 오디오 웨이브폼은 `.flac` 또는 `.wav` 오디오 파일을 `list[float]` 타입의 배열, `numpy.ndarray` 또는 `torch.Tensor`로 로드하여 얻을 수 있으며, *예를 들어* torchcodec 라이브러리(`pip install torchcodec`)나 soundfile 라이브러리(`pip install soundfile`)를 통해 가능합니다. `input_features`로 배열을 준비하려면, mel 특징 추출, 패딩, `torch.Tensor` 타입의 텐서 변환을 위해 [AutoFeatureExtractor](/docs/transformers/main/ko/model_doc/auto#transformers.AutoFeatureExtractor)를 사용해야 합니다. [__call__()](/docs/transformers/main/ko/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__)를 참조하세요.
labels (`torch.LongTensor`, shape `(batch_size,)`, *선택 사항*) : 오디오 분류/회귀 손실을 계산하는 데 사용되는 라벨. 인덱스는 `[0, ..., config.num_labels - 1]` 범위에 있어야 합니다. `config.num_labels == 1`인 경우 회귀 손실(평균 제곱 오차)이 계산되고, `config.num_labels > 1`인 경우 분류 손실(교차 엔트로피)이 계산됩니다.
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
**반환값:** [SequenceClassifierOutput](/docs/transformers/main/ko/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) 또는 `tuple(torch.Tensor)`
[ASTConfig](/docs/transformers/main/ko/model_doc/audio-spectrogram-transformer#transformers.ASTConfig) 및 입력에 따라 다양한 요소로 구성된 [SequenceClassifierOutput](/docs/transformers/main/ko/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되었거나 `config.return_dict=False`인 경우).
[ASTForAudioClassification](/docs/transformers/main/ko/model_doc/audio-spectrogram-transformer#transformers.ASTForAudioClassification)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **loss** (`torch.Tensor`, shape `(1,)`, *선택*, `labels`이 제공될 때 반환됨) -- 분류(또는 config.num_labels==1인 경우 회귀) 손실.
- **logits** (`torch.Tensor`, shape `(batch_size, config.num_labels)`) -- SoftMax 적용 전 분류(또는 config.num_labels==1인 경우 회귀) 점수.
- **hidden_states** (`tuple(torch.Tensor)`, *선택 사항*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력 1개 + 각 레이어의 출력 1개)로, 형태는 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple(torch.Tensor)`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
예:
```python
>>> from transformers import AutoFeatureExtractor, ASTForAudioClassification
>>> from datasets import load_dataset
>>> import torch
>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate
>>> feature_extractor = AutoFeatureExtractor.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
>>> model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
>>> # audio file is decoded on the fly
>>> inputs = feature_extractor(dataset[0]["audio"]["array"], sampling_rate=sampling_rate, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_ids = torch.argmax(logits, dim=-1).item()
>>> predicted_label = model.config.id2label[predicted_class_ids]
>>> predicted_label
...
>>> # compute loss - target_label is e.g. "down"
>>> target_label = model.config.id2label[0]
>>> inputs["labels"] = torch.tensor([model.config.label2id[target_label]])
>>> loss = model(**inputs).loss
>>> round(loss.item(), 2)
...
```