# BLIP-2
## 概要
BLIP-2 モデルは、Junnan Li、Dongxu Li、Silvio Savarese、Steven Hoi によって提案された [BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models](https://huggingface.co/papers/2301.12597) に記載されています。BLIP-2 は、凍結された事前学習済み画像エンコーダーと大規模言語モデル(LLM)を活用し、その間に軽量な 12 層の Transformer エンコーダーを訓練することで、各種ビジョン・言語タスクにおいて最先端の性能を実現しています。特に注目すべきは、BLIP-2 が 800 億パラメータのモデルである [Flamingo](https://huggingface.co/papers/2204.14198) を上回り、ゼロショット VQAv2 で 8.7% の向上を達成している点です。その際、訓練可能なパラメータ数は 54 分の 1 に抑えられています。
論文の抄録は以下の通りです。
*大規模モデルのエンドツーエンド学習により、ビジョン・アンド・ランゲージ事前学習のコストはますます高騰しています。本論文では、BLIP-2を提案します。BLIP-2は、オフザシェルフの凍結済み事前学習済み画像エンコーダと凍結済み大規模言語モデルからビジョン・アンド・ランゲージ事前学習をブートストラップする、汎用的かつ効率的な事前学習戦略です。BLIP-2は、2段階で事前学習される軽量なQuerying Transformerを用いて、モダリティのギャップを橋渡しします。第1段階では、凍結済み画像エンコーダからビジョン・アンド・ランゲージ表現学習をブートストラップします。第2段階では、凍結済み言語モデルからビジョン・トゥ・ランゲージ生成学習をブートストラップします。BLIP-2は、既存手法よりもはるかに少ない学習可能パラメータ数にもかかわらず、さまざまなビジョン・アンド・ランゲージタスクで最先端の性能を達成します。例えば、当社のモデルは、学習可能パラメータ数が54分の1であるにもかかわらず、ゼロショットVQAv2においてFlamingo80Bを8.7%上回っています。また、自然言語の指示に従うことができるゼロショット画像・トゥ・テキスト生成というモデルの新興能力も示しています。*
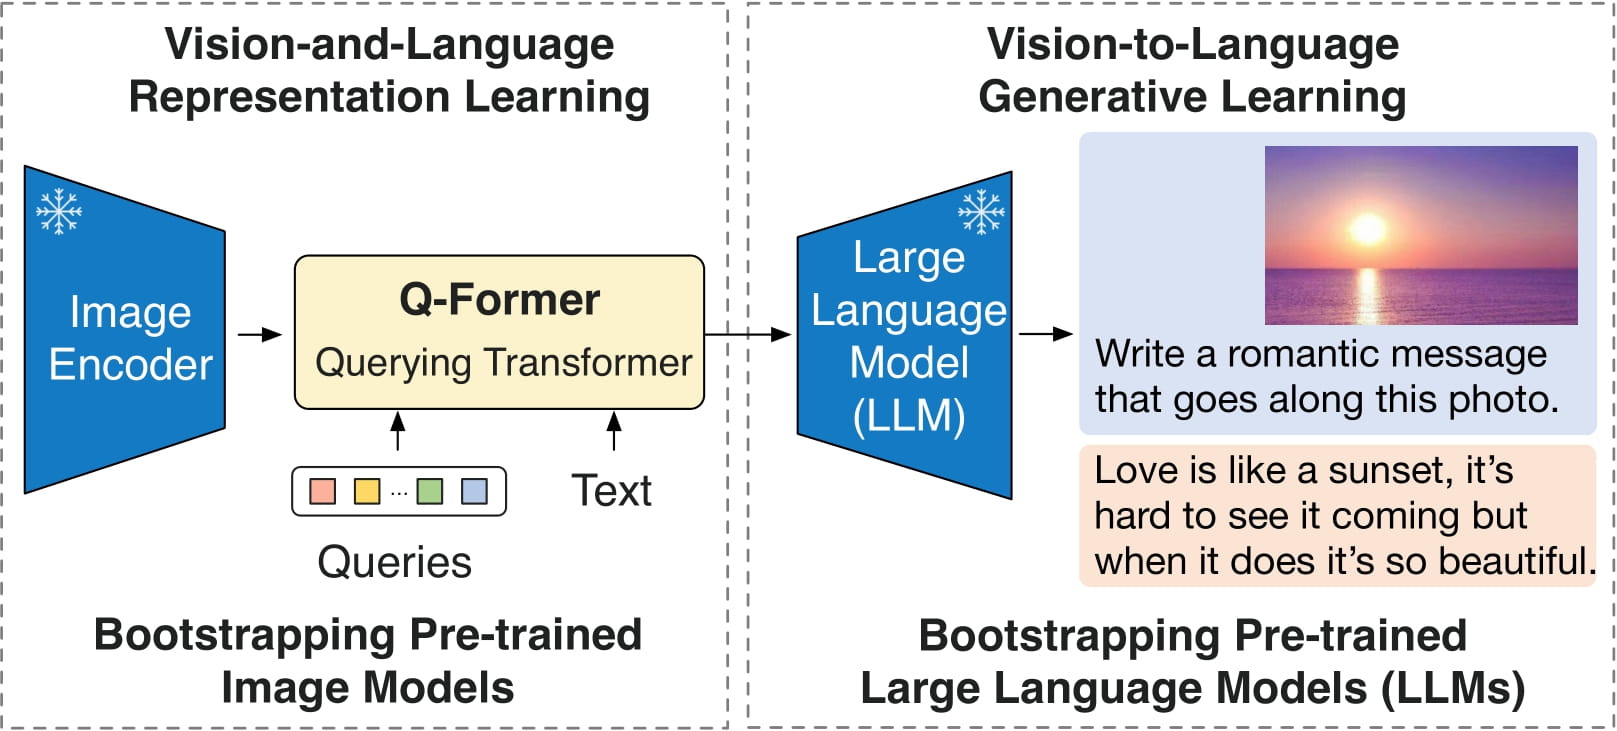 BLIP-2のアーキテクチャ。元の論文より引用。
このモデルは [nielsr](https://huggingface.co/nielsr) によって提供されました。元のコードは [こちら](https://github.com/salesforce/LAVIS/tree/5ee63d688ba4cebff63acee04adaef2dee9af207) で確認できます。
## 使用のコツ
- BLIP-2は、画像と任意のテキストプロンプトを条件として、条件付きテキスト生成に使用できます。推論時には、`generate`メソッドの使用を推奨します。
- [Blip2Processor](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Processor) を使用して、モデル用の画像を準備し、予測されたトークン ID をテキストに戻すことができます。
> [!NOTE]
> v4.46 以降の BLIP モデルでは、`processor.num_query_tokens = {{num_query_tokens}}` を追加すること、およびモデルの埋め込み層を拡張して特殊な `` トークンを追加することについて、警告が発生します。モデルのチェックポイントを所有している場合は、プロセッサーにこれらの属性を追加することを強く推奨します。所有していない場合は、プルリクエストを開いてください。これらの属性を追加すると、BLIP は画像ごとに必要なクエリトークンの数を追加し、クエリトークンと同じ数の `` プレースホルダーでテキストを拡張します。通常、画像あたり約 500 トークン必要となるため、テキストが切り捨てられないようご注意ください。切り捨てが発生すると、埋め込みのマージ時に失敗します。
これらの属性は、`model.config.num_query_tokens` などのようにモデルの config から取得でき、モデルの embeddings の拡張は [このリンク](https://gist.github.com/zucchini-nlp/e9f20b054fa322f84ac9311d9ab67042) に従って行えます。
## リソース
BLIP-2の入門を支援するための、Hugging Face公式およびコミュニティ(🌎で示されます)のリソースのリストです。
- 画像キャプション生成、視覚的質問応答(VQA)、チャット形式の会話に対応する BLIP-2 のデモノートブックは、[こちら](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/BLIP-2)で確認できます。
ここにリソースを掲載していただくことを希望される場合は、Pull Request を開いてください。レビューいたします。リソースは、既存のリソースと重複するのではなく、新しいものを示すことが望ましいです。
## Blip2Config[[transformers.Blip2Config]]
#### transformers.Blip2Config[[transformers.Blip2Config]]
```python
transformers.Blip2Config(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, qformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_query_tokens: int = 32, image_text_hidden_size: int = 256, image_token_index: int | None = None, initializer_factor: float = 1.0, initializer_range: float = 0.02)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/configuration_blip_2.py#L107)
**パラメータ:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *任意*) : ビジョンバックボーンの config オブジェクトまたは辞書。
qformer_config (`dict`、*任意*) : [Blip2QFormerConfig](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2QFormerConfig)を初期化するために使用される設定オプションの辞書。
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *任意*) : テキストバックボーンの config オブジェクトまたは辞書。
num_query_tokens (`int`、*optional*、デフォルトは 32) : Transformer に渡されるクエリトークンの数です。
image_text_hidden_size (`int`、*任意*、デフォルトは 256) : 画像とテキストの融合層の隠れ状態の次元数。
image_token_index (`int`, *任意*) : 入力画像のプレースホルダーとして使用される画像トークンのインデックス。
initializer_factor (`float`、*任意*、デフォルトは`1.0`) : すべての重み行列を初期化する係数です(1に保つ必要があります。初期化テスト用に内部で使用されます)。
initializer_range (`float`、*任意*、デフォルトは`0.02`) : すべての重み行列を初期化するためのtruncated_normal_initializerの標準偏差です。
これは、Blip 2モデルの設定を保存するための設定クラスです。指定された引数に基づいて Blip 2 モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、[Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b) と同様の設定が得られます。
設定オブジェクトは [PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) を継承し、モデルの出力を制御するために使用できます。詳細については、[PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) のドキュメントを参照してください。
例:
```python
>>> from transformers import (
... Blip2VisionConfig,
... Blip2QFormerConfig,
... OPTConfig,
... Blip2Config,
... Blip2ForConditionalGeneration,
... )
>>> # Initializing a Blip2Config with Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2Config()
>>> # Initializing a Blip2ForConditionalGeneration (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2ForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a Blip2Config from a Blip2VisionConfig, Blip2QFormerConfig and any PreTrainedConfig
>>> # Initializing BLIP-2 vision, BLIP-2 Q-Former and language model configurations
>>> vision_config = Blip2VisionConfig()
>>> qformer_config = Blip2QFormerConfig()
>>> text_config = OPTConfig()
>>> config = Blip2Config(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
```
## Blip2VisionConfig[[transformers.Blip2VisionConfig]]
#### transformers.Blip2VisionConfig[[transformers.Blip2VisionConfig]]
```python
transformers.Blip2VisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 1408, intermediate_size: int = 6144, num_hidden_layers: int = 39, num_attention_heads: int = 16, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 14, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/configuration_blip_2.py#L29)
**パラメータ:**
hidden_size (`int`、*optional*、デフォルトは`1408`) : 隠れ表現の次元数。
intermediate_size (`int`, *任意*, デフォルトは `6144`) : MLP 表現の次元数。
num_hidden_layers (`int`、*任意*、デフォルトは `39`) : Transformer デコーダーの隠れ層の数。
num_attention_heads (`int`、*任意*、デフォルトは`16`) : Transformerデコーダーの各アテンション層におけるアテンションヘッドの数。
image_size (`Union[int, list[int], tuple[int, int]]`、*任意*、デフォルトは`224`) : 各画像のサイズ(解像度)。
patch_size (`Union[int, list[int], tuple[int, int]]`、*任意*、デフォルトは`14`) : 各パッチのサイズ(解像度)。
hidden_act (`str`、*任意*、デフォルトは`gelu`) : デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、`"gelu"`、`"relu"`、`"silu"`など。
layer_norm_eps (`float`、*任意*、デフォルトは`1e-06`) : Layer Normalization 層で使用する epsilon です。
attention_dropout (`Union[float, int]`、*任意*、デフォルトは`0.0`) : 注意確率のドロップアウト率。
initializer_range (`float`、*任意*、デフォルトは `1e-10`) : 全重み行列の初期化に使用される truncated_normal_initializer の標準偏差です。
qkv_bias (`bool`, *任意*, デフォルトは `True`) : クエリ、キー、バリューにバイアスを追加するかどうか。
これは、Blip 2モデルの設定を保存するための設定クラスです。指定された引数に基づいて Blip 2 モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、[Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b) と同様の設定が得られます。
設定オブジェクトは [PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) を継承し、モデルの出力を制御するために使用できます。詳細については、[PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) のドキュメントを参照してください。
例:
```python
>>> from transformers import Blip2VisionConfig, Blip2VisionModel
>>> # Initializing a Blip2VisionConfig with Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2VisionConfig()
>>> # Initializing a Blip2VisionModel (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2VisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Blip2QFormerConfig[[transformers.Blip2QFormerConfig]]
#### transformers.Blip2QFormerConfig[[transformers.Blip2QFormerConfig]]
```python
transformers.Blip2QFormerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, cross_attention_frequency: int = 2, encoder_hidden_size: int = 1408, use_qformer_text_input: bool = False)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/configuration_blip_2.py#L64)
**パラメータ:**
vocab_size (`int`、*任意*、デフォルトは`30522`) : モデルの語彙サイズ。`input_ids`で表現できるトークンの種類数を定義します。
hidden_size (`int`、*任意*、デフォルトは`768`) : 隠れ表現の次元数。
num_hidden_layers (`int`, *任意*, デフォルトは `12`) : Transformer デコーダーの隠れ層の数。
num_attention_heads (`int`、*任意*、デフォルトは `12`) : Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。
intermediate_size (`int`、*任意*、デフォルトは `3072`) : MLP 表現の次元数。
hidden_act (`str`、*任意*、デフォルトは`gelu`) : デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、`"gelu"`、`"relu"`、`"silu"`など。
hidden_dropout_prob (`Union[float, int]`、*任意*、デフォルト値は`0.1`) : embeddings、encoder、pooler 内のすべての全結合層における dropout 確率。
attention_probs_dropout_prob (`Union[float, int]`、*任意*、デフォルトは`0.1`) : 注意確率のドロップアウト率。
max_position_embeddings (`int`、*任意*、デフォルトは`512`) : このモデルが使用される可能性のある最大シーケンス長。
initializer_range (`float`、*任意*、デフォルトは`0.02`) : すべての重み行列を初期化するためのtruncated_normal_initializerの標準偏差です。
layer_norm_eps (`float`、*任意*、デフォルトは `1e-12`) : layer normalization レイヤーで使用する epsilon。
pad_token_id (`int`, *任意*, デフォルトは `0`) : 語彙内でパディングに使用されるトークン ID。
cross_attention_frequency (`int`、*optional*、デフォルトは 2) : Transformer 層にクロスアテンションを追加する頻度。
encoder_hidden_size (`int`、*optional*、デフォルトは`1408`) : 隠れ表現の次元数。
use_qformer_text_input (`bool`, *任意*, デフォルトは `False`) : BERT 形式の埋め込みを使用するかどうか。
これは、Blip 2モデルの設定を保存するための設定クラスです。指定された引数に基づいて Blip 2 モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、[Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b) と同様の設定が得られます。
設定オブジェクトは [PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) を継承し、モデルの出力を制御するために使用できます。詳細については、[PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) のドキュメントを参照してください。
例:
```python
>>> from transformers import Blip2QFormerConfig, Blip2QFormerModel
>>> # Initializing a BLIP-2 Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2QFormerConfig()
>>> # Initializing a model (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2QFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Blip2Processor[[transformers.Blip2Processor]]
#### transformers.Blip2Processor[[transformers.Blip2Processor]]
```python
transformers.Blip2Processor(image_processor, tokenizer, num_query_tokens = None, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/processing_blip_2.py#L30)
**パラメータ:**
image_processor (`BlipImageProcessor`) : 画像プロセッサは必須の入力です。
tokenizer (`GPT2Tokenizer`) : トークナイザーは必須の入力です。
num_query_tokens (`int`, *任意*) : Qformer がクエリとして使用するトークン数。モデルの config と同じである必要があります。
Blip2Processor を構築します。画像プロセッサとトークナイザーを単一のプロセッサにラップします。
[Blip2Processor](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Processor) は、[BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) と [GPT2Tokenizer](/docs/transformers/v5.23.0/ja/model_doc/gpt2#transformers.GPT2Tokenizer) のすべての機能を提供します。詳細については、[~BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) および [~GPT2Tokenizer](/docs/transformers/v5.23.0/ja/model_doc/gpt2#transformers.GPT2Tokenizer) を参照してください。
#### __call__[[transformers.Blip2Processor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | None = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/processing_blip_2.py#L50)
**パラメータ:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *任意*) : 前処理を行う画像。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチの画像を想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、`do_rescale=False` を設定してください。
text (`Union[str, list[str]]`、*任意*) : エンコード対象のシーケンスまたはシーケンスのバッチです。各シーケンスは、文字列または文字列のリスト(プレトークナイズ済み文字列)であることができます。プレトークナイズ済み入力を渡す場合は、バッチ入力との曖昧さを避けるために `is_split_into_words=True` を設定してください。
return_mm_token_type_ids (`bool`, *kwargs*) : マルチモーダルプレースホルダトークンの位置を示すマルチモーダルトークンタイプIDを返すかどうか。
return_text_replacement_offsets (`bool`, *kwargs*) : 各マルチモーダルプレースホルダーとその置換文字列の文字オフセットを返すかどうか。
return_tensors (`str` または [TensorType](/docs/transformers/v5.23.0/ja/internal/file_utils#transformers.TensorType)、*optional*) : 設定されている場合、特定のフレームワークのテンソルを返します。受け入れ可能な値は以下の通りです: - `'pt'`: PyTorch の `torch.Tensor` オブジェクトを返します。 - `'np'`: NumPy の `np.ndarray` オブジェクトを返します。
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/ja/main_classes/processors#transformers.ProcessingKwargs), *optional*) : 各モダリティ(テキスト、画像、動画、音声)の追加処理オプション。モデル固有のパラメータは上記にリストされています。サポートされている引数の完全なリストについては、TypedDict クラスを参照してください。
**戻り値:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *optional*) -- `__call__`/`encode_plus`/`batch_encode_plus` メソッドによって返される、リスト/配列/テンソルの辞書('input_ids'、'attention_mask' など)。
- **encoding**(`tokenizers.Encoding` または `Sequence[tokenizers.Encoding]`、*任意*)-- トークナイザーが、単語/文字空間からトークン空間へのマッピングなどの追加情報を出力する fast tokenizer の場合、`tokenizers.Encoding` のインスタンス、またはそのリスト(バッチの場合)にこの情報が保持されます。
- **tensor_type** (`Union[None, str, TensorType]`、*省略可*) -- 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
- **prepend_batch_axis** (`bool`、*任意*、デフォルトは `False`) -- テンソルに変換する際にバッチ軸を追加するかどうかを指定します(`tensor_type` を参照)。パラメータ `tensor_type` が設定されている場合のみこのパラメータが有効で、*それ以外の場合は無効です*。
- **n_sequences** (`int`, *任意*) -- 各エンコーディングが表す入力シーケンスの数(不明な場合は`None`、単一のシーケンスの場合は`1`、シーケンスのペアの場合は`2`)。
## Blip2VisionModel[[transformers.Blip2VisionModel]]
#### transformers.Blip2VisionModel[[transformers.Blip2VisionModel]]
```python
transformers.Blip2VisionModel(config: Blip2VisionConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L481)
**パラメータ:**
config ([Blip2VisionConfig](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2VisionConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
特定のヘッドを上に載せず、生のhidden-statesを出力する素のBlip 2 Model。
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.Blip2VisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L501)
**パラメータ:**
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`、*任意*) : 入力画像に対応するテンソルです。ピクセル値は [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用して取得できます。詳細は [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください([Blip2Processor](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Processor) は画像の処理に [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用します)。
interpolate_pos_encoding (`bool`、*任意*、デフォルトは`False`) : 事前学習済みの位置エンコーディングを補間するかどうかを指定します。
**戻り値:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) または `tuple(torch.Tensor)`
設定([Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config))や入力に応じて、さまざまな要素で構成される、[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) または `torch.Tensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。
[Blip2VisionModel](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2VisionModel) の forward メソッドは、`__call__` という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **last_hidden_state** (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`) -- モデルの最終層の出力における隠れ状態のシーケンス。
- **pooler_output** (`torch.Tensor`、形状 `(batch_size, hidden_size)`) -- 補助的な事前学習タスクに使用される層をさらに通して処理された後、シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態です。例えば、BERT系のモデルでは、線形層とtanh活性化関数を経て処理された後の分類トークンを返します。この線形層の重みは、事前学習中の次の文予測(分類)目的から学習されます。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
## Blip2QFormerModel[[transformers.Blip2QFormerModel]]
#### transformers.Blip2QFormerModel[[transformers.Blip2QFormerModel]]
```python
transformers.Blip2QFormerModel(config: Blip2QFormerConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L848)
**パラメータ:**
config ([Blip2QFormerConfig](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2QFormerConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを参照してください。
BLIP-2 クエリングトランスフォーマー(Q-Former)。
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.Blip2QFormerModel.forward]]
```python
forward(query_embeds: Tensor, query_length: int | None = None, attention_mask: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L885)
**パラメータ:**
query_embeds (`torch.Tensor`、形状は`(batch_size, sequence_length, hidden_size)`) : 注意機構の計算で使用される隠れ状態。クロスアテンションの場合、クエリとして使用されます(つまり、キーとバリューはencoder_hidden_statesを使用します)。
query_length (`int`, *任意*) : クエリの長さです。通常、クエリトークンの数に基づいて決定されます。値が指定されない場合、query_embedsによってquery_lengthが推論されます。
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
encoder_hidden_states (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`、*任意*) : エンコーダーの最終層の出力における隠れ状態のシーケンス。モデルがデコーダーとして設定されている場合、クロスアテンションで使用されます。
encoder_attention_mask (`torch.Tensor`、形状 `(batch_size, sequence_length)`、*任意*) : エンコーダー入力のpaddingトークンインデックスに対するattentionの実行を回避するためのマスクです。モデルがデコーダーとして設定されている場合、このマスクはcross-attentionで使用されます。`[0, 1]`から選択されるマスクの値: - **マスクされない**トークンは1、 - **マスクされる**トークンは0。
**戻り値:** [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) または `tuple(torch.Tensor)`
設定([Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config))や入力に応じて、さまざまな要素で構成される、[BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) または `torch.Tensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。
[Blip2QFormerModel](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2QFormerModel)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **last_hidden_state** (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`) -- モデルの最終層の出力における隠れ状態のシーケンス。
- **pooler_output** (`torch.Tensor`、形状 `(batch_size, hidden_size)`) -- 補助的な事前学習タスクに使用される層をさらに通して処理された後、シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態です。例えば、BERT系のモデルでは、線形層とtanh活性化関数を経て処理された後の分類トークンを返します。この線形層の重みは、事前学習中の次の文予測(分類)目的から学習されます。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
- **cross_attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` と `config.add_cross_attention=True` が渡された場合、または `config.output_attentions=True` の場合に返されます) -- 各層に対応する `torch.Tensor` のタプルで、形状は `(batch_size, num_heads, sequence_length, sequence_length)` です。
クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
- **past_key_values** (`Cache`、*任意*、`use_cache=True` が渡された場合または `config.use_cache=True` の場合に返されます) -- [Cache](/docs/transformers/v5.23.0/ja/internal/generation_utils#transformers.Cache) のインスタンスです。詳細については、[kv cache ガイド](https://huggingface.co/docs/transformers/en/kv_cache)を参照してください。
自己アテンションブロック(および `config.is_encoder_decoder=True` の場合、クロスカレンションブロック)の事前計算済みヒドゥンステート(キーとバリュー)を保持します。これらは逐次デコーディングを高速化するために使用できます(`past_key_values` 入力参照)。
## Blip2Model[[transformers.Blip2Model]]
#### transformers.Blip2Model[[transformers.Blip2Model]]
```python
transformers.Blip2Model(config: Blip2Config)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L957)
**パラメータ:**
config ([Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config)) : モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
テキストと画像の特徴量を生成するためのBLIP-2モデル。このモデルは、ビジョンエンコーダー、Querying Transformer (Q-Former)、言語モデルで構成されています。
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.Blip2Model.forward]]
```python
forward(pixel_values: Tensor, input_ids: Tensor, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1152)
**パラメータ:**
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`) : 入力画像に対応するテンソルです。ピクセル値は [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用して取得できます。詳細は [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください([Blip2Processor](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Processor) は画像の処理に [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用します)。
input_ids (`torch.Tensor`、shape `(batch_size, sequence_length)`) : 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスは [AutoTokenizer](/docs/transformers/v5.23.0/ja/model_doc/auto#transformers.AutoTokenizer) を使用して取得できます。詳細については、[PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
attention_mask (`torch.LongTensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンインデックスに対する attention を行わないためのマスク。`[0, 1]` から選択されるマスク値: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor`、shape `(batch_size, target_sequence_length)`、*任意*) : 語彙におけるデコーダー入力シーケンスのトークンインデックス。[AutoTokenizer](/docs/transformers/v5.23.0/ja/model_doc/auto#transformers.AutoTokenizer) を使用してインデックスを取得できます。詳細は [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。[デコーダー入力 ID とは?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor`、shape `(batch_size, target_sequence_length)`、*任意*) : デフォルトの動作: `decoder_input_ids`内の pad トークンを無視するテンソルを生成します。デフォルトでは、causal mask も使用されます。エンコーダー・デコーダー型言語モデル (T5 など) を使用する場合にのみ関連します。
labels (`torch.LongTensor`、形状 `(batch_size, sequence_length)`、*任意*) : マスク言語モデリング損失を計算するためのラベル。インデックスは `[0, ..., config.vocab_size]` の範囲内であるか、-100 である必要があります(`input_ids` のドキュメント文字列を参照)。インデックスが `-100` に設定されたトークンは無視(マスク)され、損失は `[0, ..., config.vocab_size]` の範囲内のラベルを持つトークンに対してのみ計算されます。
interpolate_pos_encoding (`bool`、*任意*、デフォルトは`False`) : 事前学習済みの位置エンコーディングを補間するかどうかを指定します。
**戻り値:** `Blip2ForConditionalGenerationModelOutput` または `tuple(torch.Tensor)`
`Blip2ForConditionalGenerationModelOutput`、または`torch.Tensor`のタプル(`return_dict=False`が渡された場合、または`config.return_dict=False`の場合)。設定([Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config))と入力に応じて、さまざまな要素で構成されます。
[Blip2Model](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Model)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.Tensor`、*optional*、`labels` が指定された場合に返され、`torch.Tensor`、形状 `(1,)`) -- 言語モデルからの言語モデリング損失。
- **logits** (`torch.Tensor`、形状 `(batch_size, sequence_length, config.vocab_size)`) -- 言語モデルの言語モデリングヘッドの予測スコア。
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`、*任意*) -- ビジョンエンコーダーの出力。
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`、*任意*) -- Q-Former (Querying Transformer) の出力。
- **language_model_outputs** (`CausalLMOutputWithPast` または `Seq2SeqLMOutput`) -- 言語モデルの出力です。
例:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import Blip2Processor, Blip2Model
>>> import torch
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b", dtype=torch.float16)
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> prompt = "Question: how many cats are there? Answer:"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device, torch.float16)
>>> outputs = model(**inputs)
```
#### get_text_features[[transformers.Blip2Model.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, decoder_input_ids: typing.Optional[torch.Tensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L994)
**パラメータ:**
input_ids (`torch.Tensor`、shape `(batch_size, sequence_length)`) : 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスは [AutoTokenizer](/docs/transformers/v5.23.0/ja/model_doc/auto#transformers.AutoTokenizer) を使用して取得できます。詳細については、[PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor`、shape `(batch_size, target_sequence_length)`、*任意*) : 語彙におけるデコーダー入力シーケンスのトークンインデックスです。インデックスは [AutoTokenizer](/docs/transformers/v5.23.0/ja/model_doc/auto#transformers.AutoTokenizer) を使用して取得できます。詳細は [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。 [デコーダー入力 ID とは何か?](../glossary#decoder-input-ids) T5 は `decoder_input_ids` の生成の開始トークンとして `pad_token_id` を使用します。`past_key_values` を使用する場合、最後の `decoder_input_ids` のみを任意で入力すれば十分です(`past_key_values` を参照)。 `decoder_input_ids` を事前学習用に準備する方法については、[T5 Training](./t5#training) をご覧ください。
decoder_attention_mask (`torch.BoolTensor`、shape `(batch_size, target_sequence_length)`、*任意*) : デフォルトの動作: `decoder_input_ids`内のpadトークンを無視するテンソルを生成します。デフォルトでは、causal maskも使用されます。
labels (`torch.Tensor`、形状 `(batch_size, sequence_length)`、*任意*) : マスク言語モデリング損失を計算するためのラベル。インデックスは `[0, ..., config.vocab_size]` の範囲内であるか、-100 である必要があります(`input_ids` のドキュメント文字列を参照)。インデックスが `-100` に設定されたトークンは無視(マスク)され、損失は `[0, ..., config.vocab_size]` の範囲内のラベルを持つトークンに対してのみ計算されます。
**戻り値:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) または `tuple(torch.Tensor)`
設定([Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config))や入力に応じて、さまざまな要素で構成される、[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) または `torch.Tensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。
- **last_hidden_state** (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`) -- モデルの最終層の出力における隠れ状態のシーケンス。
- **pooler_output** (`torch.Tensor`、形状 `(batch_size, hidden_size)`) -- 補助的な事前学習タスクに使用される層をさらに通して処理された後、シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態です。例えば、BERT系のモデルでは、線形層とtanh活性化関数を経て処理された後の分類トークンを返します。この線形層の重みは、事前学習中の次の文予測(分類)目的から学習されます。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
```python
>>> import torch
>>> from transformers import AutoTokenizer, Blip2Model
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> tokenizer = AutoTokenizer.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> inputs = tokenizer(["a photo of a cat"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.Blip2Model.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1056)
**パラメータ:**
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`) : 入力画像に対応するテンソルです。ピクセル値は [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用して取得できます。詳細は [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください([Blip2Processor](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Processor) は画像の処理に [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用します)。
interpolate_pos_encoding (`bool`、*任意*、デフォルトは`False`) : 事前学習済みの位置エンコーディングを補間するかどうかを指定します。
**戻り値:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) または `tuple(torch.Tensor)`
設定([Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config))や入力に応じて、さまざまな要素で構成される、[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) または `torch.Tensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。
- **last_hidden_state** (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`) -- モデルの最終層の出力における隠れ状態のシーケンス。
- **pooler_output** (`torch.Tensor`、形状 `(batch_size, hidden_size)`) -- 補助的な事前学習タスクに使用される層をさらに通して処理された後、シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態です。例えば、BERT系のモデルでは、線形層とtanh活性化関数を経て処理された後の分類トークンを返します。この線形層の重みは、事前学習中の次の文予測(分類)目的から学習されます。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2Model
>>> from transformers.image_utils import load_image
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_outputs = model.get_image_features(**inputs)
```
#### get_qformer_features[[transformers.Blip2Model.get_qformer_features]]
```python
get_qformer_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1087)
**パラメータ:**
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`) : 入力画像に対応するテンソルです。ピクセル値は [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用して取得できます。詳細は [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください([Blip2Processor](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Processor) は画像の処理に [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用します)。
interpolate_pos_encoding (`bool`、*任意*、デフォルトは`False`) : 事前学習済みの位置エンコーディングを補間するかどうかを指定します。
**戻り値:** qformer_outputs (`torch.Tensor`)
Q-Formerモデルの最終層の隠れ状態。
例:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2Model
>>> from transformers.image_utils import load_image
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... qformer_outputs = model.get_qformer_features(**inputs)
```
## Blip2ForConditionalGeneration[[transformers.Blip2ForConditionalGeneration]]
#### transformers.Blip2ForConditionalGeneration[[transformers.Blip2ForConditionalGeneration]]
```python
transformers.Blip2ForConditionalGeneration(config: Blip2Config)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1460)
**パラメータ:**
config ([Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config)) : モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
画像と任意のテキストプロンプトを指定してテキストを生成するためのBLIP-2モデル。このモデルは、ビジョンエンコーダー、Querying Transformer (Q-Former)、および言語モデルで構成されています。
モデルに`input_ids`を任意で渡すことができます。これはテキストのプロンプトとして機能し、言語モデルがそのプロンプトを継続するようにします。渡さない場合、言語モデルは[BOS](シーケンスの開始)トークンからテキストの生成を開始します。
Flan-T5のチェックポイントはfloat16にキャストできないことに注意してください。これらはbfloat16で事前学習されています。
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.Blip2ForConditionalGeneration.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1587)
**パラメータ:**
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`) : 入力画像に対応するテンソルです。ピクセル値は [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用して取得できます。詳細は [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください([Blip2Processor](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Processor) は画像の処理に [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用します)。
input_ids (`torch.LongTensor`、形状 `(batch_size, sequence_length)`、*任意*) : 言語モデルの語彙における入力シーケンスのトークンインデックスです。入力トークンは任意で指定でき、言語モデルが継続するためのテキストプロンプトとして機能します。インデックスは [Blip2Processor](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Processor) を使用して取得できます。詳細は [Blip2Processor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Processor.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
attention_mask (`torch.LongTensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンインデックスに対する attention を行わないためのマスク。`[0, 1]` から選択されるマスク値: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor`、shape `(batch_size, target_sequence_length)`、*任意*) : 語彙におけるデコーダー入力シーケンスのトークンインデックス。[AutoTokenizer](/docs/transformers/v5.23.0/ja/model_doc/auto#transformers.AutoTokenizer) を使用してインデックスを取得できます。詳細は [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。[デコーダー入力 ID とは?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor`、shape `(batch_size, target_sequence_length)`、*任意*) : デフォルトの動作: `decoder_input_ids`内の pad トークンを無視するテンソルを生成します。デフォルトでは、causal mask も使用されます。エンコーダー・デコーダー型言語モデル (T5 など) を使用する場合にのみ関連します。
inputs_embeds (`torch.Tensor`、shape `(batch_size, sequence_length, hidden_size)`、*任意*) : `input_ids` を渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、`input_ids` のインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
labels (`torch.LongTensor`、形状 `(batch_size, sequence_length)`、*任意*) : マスク言語モデリング損失を計算するためのラベル。インデックスは `[0, ..., config.vocab_size]` の範囲内であるか、-100 である必要があります(`input_ids` のドキュメント文字列を参照)。インデックスが `-100` に設定されたトークンは無視(マスク)され、損失は `[0, ..., config.vocab_size]` の範囲内のラベルを持つトークンに対してのみ計算されます。
interpolate_pos_encoding (`bool`、*任意*、デフォルトは`False`) : 事前学習済みの位置エンコーディングを補間するかどうかを指定します。
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *任意*) : キーがサポートされているモダリティ、値がそのモダリティのエンコード済み出力である辞書。各エンコード済み出力は、(`pooler_output`、*任意*: `last_hidden_states`、*任意*: `hidden_states`、*任意*: `attentions`) という形式のタプルで、`pooler_output` の形状は `(batch_size, sequence_length, hidden_size)`、*任意*) であり、エンコーダーのマルチモーダル特徴量をテキスト埋め込みにマージしたシーケンスです。
**戻り値:** `Blip2ForConditionalGenerationModelOutput` または `tuple(torch.Tensor)`
`Blip2ForConditionalGenerationModelOutput`、または`torch.Tensor`のタプル(`return_dict=False`が渡された場合、または`config.return_dict=False`の場合)。設定([Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config))と入力に応じて、さまざまな要素で構成されます。
[Blip2ForConditionalGeneration](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2ForConditionalGeneration)のforwardメソッドは、`__call__`という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.Tensor`、*optional*、`labels` が指定された場合に返され、`torch.Tensor`、形状 `(1,)`) -- 言語モデルからの言語モデリング損失。
- **logits** (`torch.Tensor`、形状 `(batch_size, sequence_length, config.vocab_size)`) -- 言語モデルの言語モデリングヘッドの予測スコア。
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`、*任意*) -- ビジョンエンコーダーの出力。
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`、*任意*) -- Q-Former (Querying Transformer) の出力。
- **language_model_outputs** (`CausalLMOutputWithPast` または `Seq2SeqLMOutput`) -- 言語モデルの出力です。
例:
プロセッサ、モデル、画像入力の準備
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import Blip2Processor, Blip2ForConditionalGeneration
>>> import torch
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2ForConditionalGeneration.from_pretrained(
... "Salesforce/blip2-opt-2.7b", load_in_8bit=True, device_map={"": 0}, dtype=torch.float16
... ) # doctest: +IGNORE_RESULT
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
```
画像キャプション生成(テキストプロンプトなし):
```python
>>> inputs = processor(images=image, return_tensors="pt").to(device, torch.float16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two cats laying on a couch
```
視覚的質問応答(prompt = question):
```python
>>> prompt = "Question: how many cats are there? Answer:"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device="cuda", dtype=torch.float16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two
```
[bitsandbytes](https://github.com/TimDettmers/bitsandbytes) を通じた int8 推論もサポートされていることに注意してください。これにより、モデルが使用するメモリ量を大幅に削減しながら、同じパフォーマンスを維持できます。
```python
>>> model = Blip2ForConditionalGeneration.from_pretrained(
... "Salesforce/blip2-opt-2.7b", load_in_8bit=True, device_map={"": 0}, dtype=torch.bfloat16
... ) # doctest: +IGNORE_RESULT
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device="cuda", dtype=torch.bfloat16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two
```
#### generate[[transformers.Blip2ForConditionalGeneration.generate]]
```python
generate(pixel_values: Tensor, input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **generate_kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1738)
**パラメータ:**
pixel_values (`torch.Tensor`、shape: (batch_size, num_channels, height, width)) : 処理対象の入力画像。
input_ids (`torch.LongTensor`、shape (batch_size, sequence_length)、*任意*) : 生成のプロンプトとして使用されるシーケンス。
attention_mask (`torch.LongTensor`、shape (batch_size, sequence_length)、*任意*) : padding トークンのインデックスに対する attention を行わないようにするためのマスク
inputs_embeds (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`) : 入力の埋め込み表現です。int トークンではなく、float である必要があります。
interpolate_pos_encoding (`bool`、*任意*、デフォルトは`False`) : 画像埋め込みの位置エンコーディングを補間するかどうかを指定します。
**戻り値:** `captions (list)`
長さ batch_size * num_captions の文字列のリスト。
`generate`関数をオーバーライドし、モデルを条件付きジェネレーターとして使用できるようにします。
#### get_image_features[[transformers.Blip2ForConditionalGeneration.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1519)
**パラメータ:**
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`) : 入力画像に対応するテンソル。
interpolate_pos_encoding (`bool`、*任意*、デフォルトは`False`) : 事前学習済みの位置エンコーディングを補間するかどうかを指定します。
**戻り値:** `BaseModelOutputWithVisionQformerOutputs` または `tuple(torch.Tensor)`
`BaseModelOutputWithVisionQformerOutputs` または `torch.Tensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。[Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config) および入力に応じて、さまざまな要素で構成されます。
- **last_hidden_state** (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`) -- モデルの最終層の出力における隠れ状態のシーケンス。
- **pooler_output** (`torch.Tensor`、形状 `(batch_size, hidden_size)`) -- 補助的な事前学習タスクに使用される層をさらに通して処理された後、シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態です。例えば、BERT系のモデルでは、線形層とtanh活性化関数を経て処理された後の分類トークンを返します。この線形層の重みは、事前学習中の次の文予測(分類)目的から学習されます。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`、*任意*) -- ビジョンエンコーダーの出力。
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`、*任意*) -- Q-Former (Querying Transformer) の出力。
例:
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, Blip2ForConditionalGeneration
>>> model = Blip2ForConditionalGeneration.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```
## Blip2ForImageTextRetrieval[[transformers.Blip2ForImageTextRetrieval]]
#### transformers.Blip2ForImageTextRetrieval[[transformers.Blip2ForImageTextRetrieval]]
```python
transformers.Blip2ForImageTextRetrieval(config: Blip2Config)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1832)
**パラメータ:**
config ([Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config)) : モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
ビジョンとテキストのプロジェクトア、およびその上に分類ヘッドを備えたBLIP-2モデル。このモデルは、画像とテキストの検索の文脈で使用されます。画像とテキストが与えられると、モデルはテキストが画像に関連している確率を返します。
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.Blip2ForImageTextRetrieval.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, attention_mask: typing.Optional[torch.LongTensor] = None, use_image_text_matching_head: bool | None = False, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1866)
**パラメータ:**
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`) : 入力画像に対応するテンソルです。ピクセル値は [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用して取得できます。詳細は [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください([Blip2Processor](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Processor) は画像の処理に [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用します)。
input_ids (`torch.LongTensor`、形状 `(batch_size, sequence_length)`、*任意*) : 言語モデルの語彙における入力シーケンスのトークンインデックスです。入力トークンは任意で指定でき、言語モデルが継続するためのテキストプロンプトとして機能します。インデックスは [Blip2Processor](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Processor) を使用して取得できます。詳細は [Blip2Processor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Processor.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
attention_mask (`torch.LongTensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンインデックスに対する attention を行わないためのマスク。`[0, 1]` から選択されるマスク値: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
use_image_text_matching_head (`bool`, *任意*) : Image-Text Matching または Contrastive スコアを返すかどうかを指定します。
output_attentions (`bool`, *任意*) : すべてのアテンション層のアテンションテンソルを返すかどうか。詳細は、返されるテンソルの `attentions` を参照してください。
output_hidden_states (`bool`, *任意*) : 全レイヤーの hidden states を返すかどうかを指定します。詳細は、返されるテンソルの `hidden_states` を参照してください。
return_dict (`bool`, *任意*) : プレーンなタプルではなく [ModelOutput](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.utils.ModelOutput) を返すかどうか。
**戻り値:** `Blip2ImageTextMatchingModelOutput` または `tuple(torch.Tensor)`
`Blip2ImageTextMatchingModelOutput`、または`torch.Tensor`のタプル(`return_dict=False`が渡された場合、または`config.return_dict=False`の場合)。設定([Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config))と入力に応じて、さまざまな要素で構成されます。
[Blip2ForImageTextRetrieval](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2ForImageTextRetrieval) の forward メソッドは、`__call__` という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.Tensor`、shape `(1,)`、*optional*、`return_loss` が `True` の場合のみ返されます) -- 画像とテキストの類似度に対する対比損失。
- **logits_per_image** (`torch.Tensor`、形状 `(image_batch_size, text_batch_size)`) -- `image_embeds` と `text_embeds` 間のスケーリング済みドット積スコアです。これは画像とテキストの類似度スコアを表します。
- **logits_per_text** (`torch.Tensor`、形状 `(text_batch_size, image_batch_size)`) -- `text_embeds` と `image_embeds` 間のスケーリング済みドット積スコアです。これはテキストと画像の類似度スコアを表します。
- **text_embeds** (`torch.Tensor`、形状 `(batch_size, output_dim`) -- プールされた出力に投影層を適用して得られたテキスト埋め込み。
- **image_embeds** (`torch.Tensor`、形状 `(batch_size, output_dim`) -- プールされた出力に投影層を適用して得られた画像埋め込み。
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`、*任意*) -- [Blip2QFormerModel](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2QFormerModel) の出力です。
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`、*任意*) -- [Blip2VisionModel](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2VisionModel) の出力です。
例:
```python
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, Blip2ForImageTextRetrieval
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model = Blip2ForImageTextRetrieval.from_pretrained("Salesforce/blip2-itm-vit-g", dtype=torch.float16)
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "two cats laying on a pink blanket"
>>> inputs = processor(images=image, text=text, return_tensors="pt").to(device, torch.float16)
>>> itm_out = model(**inputs, use_image_text_matching_head=True)
>>> logits_per_image = torch.nn.functional.softmax(itm_out.logits_per_image, dim=1)
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(f"{probs[0][0]:.1%} that image 0 is not '{text}'")
26.9% that image 0 is not 'two cats laying on a pink blanket'
>>> print(f"{probs[0][1]:.1%} that image 0 is '{text}'")
73.0% that image 0 is 'two cats laying on a pink blanket'
>>> texts = ["a photo of a cat", "a photo of a dog"]
>>> inputs = processor(images=image, text=texts, return_tensors="pt").to(device, torch.float16)
>>> itc_out = model(**inputs, use_image_text_matching_head=False)
>>> logits_per_image = itc_out.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(f"{probs[0][0]:.1%} that image 0 is '{texts[0]}'")
55.3% that image 0 is 'a photo of a cat'
>>> print(f"{probs[0][1]:.1%} that image 0 is '{texts[1]}'")
44.7% that image 0 is 'a photo of a dog'
```
## Blip2TextModelWithProjection[[transformers.Blip2TextModelWithProjection]]
#### transformers.Blip2TextModelWithProjection[[transformers.Blip2TextModelWithProjection]]
```python
transformers.Blip2TextModelWithProjection(config: Blip2Config)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1274)
**パラメータ:**
config ([Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config)) : モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
プーリング出力の上に線形層を配置した投影層を備えた Blip 2 モデル。
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.Blip2TextModelWithProjection.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1298)
**パラメータ:**
input_ids (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスは [AutoTokenizer](/docs/transformers/v5.23.0/ja/model_doc/auto#transformers.AutoTokenizer) を使用して取得できます。詳細については、[PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
position_ids (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。`[0, config.n_positions - 1]` の範囲から選択されます。 [位置 ID とは何か?](../glossary#position-ids)
**戻り値:** `Blip2TextModelOutput` または `tuple(torch.Tensor)`
`Blip2TextModelOutput`、または`torch.Tensor`のタプル(`return_dict=False`が渡された場合、または`config.return_dict=False`の場合)。[Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config)および入力に応じて、さまざまな要素で構成されます。
[Blip2TextModelWithProjection](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2TextModelWithProjection)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **text_embeds** (`torch.Tensor`、形状 `(batch_size, output_dim)`、*任意*、モデルが `with_projection=True` で初期化された場合に返されます) -- pooler_output に投影層を適用して得られるテキスト埋め込みです。
- **last_hidden_state** (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`、*任意*) -- モデルの最終層の出力における隠れ状態のシーケンス。
- **hidden_states** (`tuple[torch.Tensor, ...]`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple[torch.Tensor, ...]`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)` です。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2TextModelWithProjection
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model = Blip2TextModelWithProjection.from_pretrained(
... "Salesforce/blip2-itm-vit-g", dtype=torch.float16
... )
>>> model.to(device)
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> inputs = processor(text=["a photo of a cat", "a photo of a dog"], return_tensors="pt").to(device)
>>> outputs = model(**inputs)
>>> text_embeds = outputs.text_embeds
>>> print(text_embeds.shape)
torch.Size([2, 7, 256])
```
## Blip2VisionModelWithProjection[[transformers.Blip2VisionModelWithProjection]]
#### transformers.Blip2VisionModelWithProjection[[transformers.Blip2VisionModelWithProjection]]
```python
transformers.Blip2VisionModelWithProjection(config: Blip2Config)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1359)
**パラメータ:**
config ([Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config)) : モデルのすべてのパラメータを含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
プーリング出力の上に線形層を配置した投影層を備えた Blip 2 モデル。
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.Blip2VisionModelWithProjection.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/blip_2/modeling_blip_2.py#L1382)
**パラメータ:**
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`、*任意*) : 入力画像に対応するテンソルです。ピクセル値は [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用して取得できます。詳細は [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください([Blip2Processor](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Processor) は画像の処理に [BlipImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/blip#transformers.BlipImageProcessor) を使用します)。
**戻り値:** `Blip2VisionModelOutput` または `tuple(torch.Tensor)`
`Blip2VisionModelOutput` または `torch.Tensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。構成([Blip2Config](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2Config))および入力に応じて、さまざまな要素で構成されます。
[Blip2VisionModelWithProjection](/docs/transformers/v5.23.0/ja/model_doc/blip-2#transformers.Blip2VisionModelWithProjection)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **image_embeds** (`torch.Tensor`、形状 `(batch_size, output_dim)`、*任意*、モデルが `with_projection=True` で初期化された場合に返されます) -- pooler_output に投影層を適用して得られる画像埋め込みです。
- **last_hidden_state** (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`、*任意*) -- モデルの最終層の出力における隠れ状態のシーケンス。
- **hidden_states** (`tuple[torch.Tensor, ...]`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(埋め込み層を持つモデルの場合、埋め込みの出力用が 1 つ、各層の出力用が 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple[torch.Tensor, ...]`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)` です。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2VisionModelWithProjection
>>> from transformers.image_utils import load_image
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> model = Blip2VisionModelWithProjection.from_pretrained(
... "Salesforce/blip2-itm-vit-g", dtype=torch.float16
... )
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt").to(device, torch.float16)
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> image_embeds = outputs.image_embeds
>>> print(image_embeds.shape)
torch.Size([1, 32, 256])
```