
Diffusers documentation
Kandinsky 2.1
Kandinsky 2.1
Kandinsky 2.1 dibuat oleh Arseniy Shakhmatov, Anton Razzhigaev, Aleksandr Nikolich, Vladimir Arkhipkin, Igor Pavlov, Andrey Kuznetsov, dan Denis Dimitrov.
Deskripsi dari halaman GitHub-nya adalah:
Kandinsky 2.1 mewarisi praktik terbaik dari Dall-E 2 dan Latent diffusion, sambil memperkenalkan beberapa ide baru. Sebagai encoder teks dan gambar, model ini menggunakan model CLIP dan prior (pemetaan) difusi gambar di antara ruang laten dari modalitas CLIP. Pendekatan ini meningkatkan kinerja visual model dan membuka cakrawala baru dalam penggabungan gambar serta manipulasi gambar yang dipandu teks.
Kodebase asli dapat ditemukan di ai-forever/Kandinsky-2.
Lihat organisasi Kandinsky Community di Hub untuk checkpoint model resmi untuk tugas seperti text-to-image, image-to-image, dan inpainting.
Pastikan untuk melihat panduan Schedulers untuk mempelajari cara mengeksplorasi tradeoff antara kecepatan dan kualitas scheduler, serta lihat bagian reuse components across pipelines untuk mempelajari cara memuat komponen yang sama secara efisien ke dalam beberapa pipeline.
Pastikan Anda telah menginstal pustaka berikut.
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate
Penggunaan Kandinsky 2.1 dan 2.2 sangat mirip! Satu-satunya perbedaan adalah Kandinsky 2.2 tidak menerima
promptsebagai input saat mendekode latents. Sebagai gantinya, Kandinsky 2.2 hanya menerimaimage_embedsselama proses decoding.
Kandinsky 3 memiliki arsitektur yang lebih ringkas dan tidak memerlukan model sebelumnya. Artinya, cara penggunaannya identik dengan model difusi lainnya seperti Stable Diffusion XL.
Teks-ke-gambar
Untuk menggunakan model Kandinsky untuk tugas apa pun, Anda selalu memulai dengan menyiapkan pipeline prior untuk mengkodekan prompt dan menghasilkan image embeddings. Pipeline prior juga menghasilkan negative_image_embeds yang sesuai dengan negative prompt "". Untuk hasil yang lebih baik, Anda dapat meneruskan negative_prompt yang sebenarnya ke pipeline prior, tetapi ini akan meningkatkan ukuran batch efektif dari pipeline prior sebesar 2x.
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt, guidance_scale=1.0).to_tuple()
Sekarang, kirimkan semua prompt dan embedding ke KandinskyPipeline untuk menghasilkan gambar:
image = pipeline(prompt, image_embeds=image_embeds, negative_prompt=negative_prompt, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
import torch

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, guidance_scale=1.0).to_tuple()
Lewatkan image_embeds dan negative_image_embeds ke KandinskyV22Pipeline untuk menghasilkan gambar:
image = pipeline(image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
Kandinsky 3 tidak memerlukan model sebelumnya sehingga Anda dapat langsung memuat Kandinsky3Pipeline dan memberikan prompt untuk menghasilkan gambar:
from diffusers import Kandinsky3Pipeline
import torch

pipeline = Kandinsky3Pipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
image = pipeline(prompt).images[0]
image
🤗 Diffusers juga menyediakan API end-to-end dengan KandinskyCombinedPipeline dan KandinskyV22CombinedPipeline, yang berarti Anda tidak perlu memuat pipeline prior dan text-to-image secara terpisah. Pipeline gabungan ini secara otomatis memuat model prior dan decoder. Anda tetap dapat mengatur nilai yang berbeda untuk pipeline prior dengan parameter prior_guidance_scale dan prior_num_inference_steps jika diinginkan.
Gunakan AutoPipelineForText2Image untuk memanggil pipeline gabungan secara otomatis di baliknya:
from diffusers import AutoPipelineForText2Image
import torch

pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imagefrom diffusers import AutoPipelineForText2Image
import torch
pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imageGambar-ke-gambar
Untuk image-to-image, berikan gambar awal dan prompt teks untuk mengondisikan gambar ke pipeline. Mulai dengan memuat pipeline prior:
import torch
from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyImg2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")import torch
from diffusers import KandinskyV22Img2ImgPipeline, KandinskyPriorPipeline
prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")Kandinsky 3 tidak memerlukan model sebelumnya sehingga Anda dapat langsung memuat pipeline image-to-image:
from diffusers import Kandinsky3Img2ImgPipeline
from diffusers.utils import load_image
import torch

pipeline = Kandinsky3Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
Unduh gambar untuk dikondisikan:
from diffusers.utils import load_image

# download image
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image = original_image.resize((768, 512))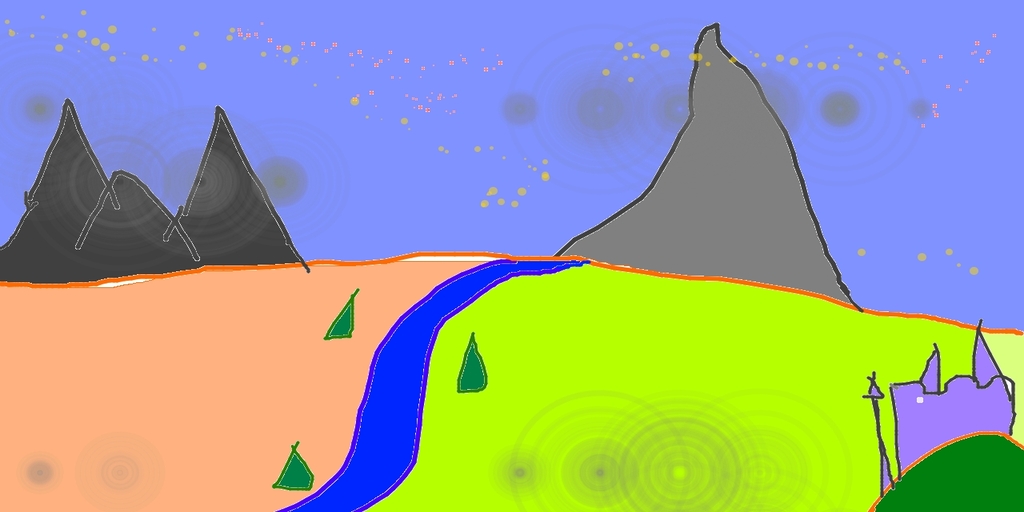
Buat image_embeds dan negative_image_embeds dengan pipeline sebelumnya:
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt).to_tuple()
Sekarang, lewati gambar asli, serta semua prompt dan embedding ke pipeline untuk menghasilkan gambar:
from diffusers.utils import make_image_grid

image = pipeline(prompt, negative_prompt=negative_prompt, image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
from diffusers.utils import make_image_grid

image = pipeline(image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
image = pipeline(prompt, negative_prompt=negative_prompt, image=image, strength=0.75, num_inference_steps=25).images[0]
image
🤗 Diffusers juga menyediakan API end-to-end dengan KandinskyImg2ImgCombinedPipeline dan KandinskyV22Img2ImgCombinedPipeline, yang berarti Anda tidak perlu memuat pipeline prior dan image-to-image secara terpisah. Pipeline gabungan ini secara otomatis memuat model prior dan decoder. Anda tetap dapat mengatur nilai yang berbeda untuk pipeline prior dengan parameter prior_guidance_scale dan prior_num_inference_steps jika diinginkan.
Gunakan AutoPipelineForImage2Image untuk memanggil pipeline gabungan secara otomatis di balik layar:
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch

pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True)
pipeline.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)

original_image.thumbnail((768, 768))

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch
pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image.thumbnail((768, 768))
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)Inpainting
⚠️ Model Kandinsky sekarang menggunakan ⬜️ piksel putih untuk mewakili area yang dimasker, bukan piksel hitam. Jika Anda menggunakan KandinskyInpaintPipeline di produksi, Anda perlu mengubah mask untuk menggunakan piksel putih:
# For PIL input
import PIL.ImageOps
mask = PIL.ImageOps.invert(mask)

# For PyTorch and NumPy input
mask = 1 - mask
Untuk inpainting, Anda memerlukan gambar asli, mask dari area yang akan diganti pada gambar asli, dan prompt teks tentang apa yang akan di-inpaint. Muat pipeline sebelumnya:
from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyInpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")from diffusers import KandinskyV22InpaintPipeline, KandinskyV22PriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22InpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")Muat gambar awal dan buat mask:
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
Buat embedding dengan pipeline sebelumnya:
prompt = "a hat"
prior_output = prior_pipeline(prompt)
Sekarang, berikan gambar awal, mask, prompt, dan embeddings ke pipeline untuk menghasilkan gambar:
output_image = pipeline(prompt, image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
output_image = pipeline(image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
Anda juga dapat menggunakan KandinskyInpaintCombinedPipeline dan KandinskyV22InpaintCombinedPipeline end-to-end untuk memanggil pipeline prior dan decoder secara bersamaan di balik layar. Gunakan AutoPipelineForInpainting untuk ini:
import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid

pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()

init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"

output_image = pipe(prompt=prompt, image=init_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid
pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"
output_image = pipe(prompt=prompt, image=original_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)Interpolasi
Interpolasi memungkinkan Anda untuk menjelajahi ruang laten antara embedding gambar dan teks, yang merupakan cara menarik untuk melihat beberapa output antara dari model prior. Muat pipeline prior dan dua gambar yang ingin Anda interpolasi:
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
from diffusers.utils import load_image, make_image_grid
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
from diffusers.utils import load_image, make_image_grid
import torch
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)

Tentukan teks atau gambar yang akan diinterpolasi, dan atur bobot untuk setiap teks atau gambar. Eksperimenlah dengan bobot untuk melihat bagaimana pengaruhnya terhadap interpolasi!
images_texts = ["a cat", img_1, img_2]
weights = [0.3, 0.3, 0.4]
Panggil fungsi interpolate untuk menghasilkan embeddings, lalu teruskan ke pipeline untuk menghasilkan gambar:
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
ControlNet
⚠️ ControlNet hanya didukung untuk Kandinsky 2.2!
ControlNet memungkinkan kondisioning model difusi pretrained berskala besar dengan input tambahan seperti peta kedalaman atau deteksi tepi. Sebagai contoh, Anda dapat mengondisikan Kandinsky 2.2 dengan peta kedalaman agar model memahami dan mempertahankan struktur dari gambar kedalaman tersebut.
Mari kita muat sebuah gambar dan ekstrak peta kedalamannya:
from diffusers.utils import load_image

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))
img
Lalu Anda dapat menggunakan Pipeline depth-estimation dari 🤗 Transformers untuk memproses gambar dan mengambil peta kedalaman:
import torch
import numpy as np

from transformers import pipeline

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
Teks-ke-gambar
Muat pipeline sebelumnya dan KandinskyV22ControlnetPipeline:
from diffusers import KandinskyV22PriorPipeline, KandinskyV22ControlnetPipeline

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
Buat embedding gambar dari prompt dan negative prompt:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

image_emb, zero_image_emb = prior_pipeline(
    prompt=prompt, negative_prompt=negative_prior_prompt, generator=generator
).to_tuple()
Terakhir, berikan embedding gambar dan gambar kedalaman ke KandinskyV22ControlnetPipeline untuk menghasilkan gambar:
image = pipeline(image_embeds=image_emb, negative_image_embeds=zero_image_emb, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
image
Gambar-ke-gambar
Untuk image-to-image dengan ControlNet, Anda perlu menggunakan:
- KandinskyV22PriorEmb2EmbPipeline untuk menghasilkan embedding gambar dari prompt teks dan gambar
- KandinskyV22ControlnetImg2ImgPipeline untuk menghasilkan gambar dari gambar awal dan embedding gambar
Proses dan ekstrak peta kedalaman dari gambar awal seekor kucing menggunakan Pipeline depth-estimation dari 🤗 Transformers:
import torch
import numpy as np

from diffusers import KandinskyV22PriorEmb2EmbPipeline, KandinskyV22ControlnetImg2ImgPipeline
from diffusers.utils import load_image
from transformers import pipeline

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
Muat pipeline sebelumnya dan KandinskyV22ControlnetImg2ImgPipeline:
prior_pipeline = KandinskyV22PriorEmb2EmbPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetImg2ImgPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
Lewatkan prompt teks dan gambar awal ke pipeline prior untuk menghasilkan embedding gambar:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

img_emb = prior_pipeline(prompt=prompt, image=img, strength=0.85, generator=generator)
negative_emb = prior_pipeline(prompt=negative_prior_prompt, image=img, strength=1, generator=generator)
Sekarang Anda dapat menjalankan KandinskyV22ControlnetImg2ImgPipeline untuk menghasilkan gambar dari gambar awal dan embedding gambar:
image = pipeline(image=img, strength=0.5, image_embeds=img_emb.image_embeds, negative_image_embeds=negative_emb.image_embeds, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
make_image_grid([img.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
Optimasi
Kandinsky unik karena memerlukan pipeline awal untuk menghasilkan pemetaan, dan pipeline kedua untuk mendekode latents menjadi gambar. Upaya optimasi sebaiknya difokuskan pada pipeline kedua karena di situlah sebagian besar komputasi dilakukan. Berikut adalah beberapa tips untuk meningkatkan Kandinsky selama inferensi.
- Aktifkan xFormers jika Anda menggunakan PyTorch < 2.0:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_xformers_memory_efficient_attention()- Aktifkan
torch.compilejika Anda menggunakan PyTorch >= 2.0 untuk secara otomatis menggunakan scaled dot-product attention (SDPA):
  pipe.unet.to(memory_format=torch.channels_last)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
Ini sama dengan secara eksplisit mengatur prosesor perhatian untuk menggunakan AttnAddedKVProcessor2_0:
from diffusers.models.attention_processor import AttnAddedKVProcessor2_0

pipe.unet.set_attn_processor(AttnAddedKVProcessor2_0())- Offload model ke CPU dengan enable_model_cpu_offload() untuk menghindari error out-of-memory:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_model_cpu_offload()- Secara default, pipeline teks-ke-gambar menggunakan DDIMScheduler tetapi Anda dapat menggantinya dengan scheduler lain seperti DDPMScheduler untuk melihat bagaimana hal itu memengaruhi tradeoff antara kecepatan inferensi dan kualitas gambar:
from diffusers import DDPMScheduler
from diffusers import DiffusionPipeline

scheduler = DDPMScheduler.from_pretrained("kandinsky-community/kandinsky-2-1", subfolder="ddpm_scheduler")
pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", scheduler=scheduler, dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
KandinskyPriorPipeline
kelas diffusers.KandinskyPriorPipeline
< source >( prior: PriorTransformerimage_encoder: CLIPVisionModelWithProjectiontext_encoder: CLIPTextModelWithProjectiontokenizer: CLIPTokenizerscheduler: UnCLIPSchedulerimage_processor: CLIPImageProcessorPil )
Parameter
- prior (PriorTransformer) — prior unCLIP kanonik untuk mengaproksimasi embedding gambar dari embedding teks.
- image_encoder (
CLIPVisionModelWithProjection) — Encoder gambar yang dibekukan. - text_encoder (
CLIPTextModelWithProjection) — Text-encoder yang dibekukan. - tokenizer (
CLIPTokenizer) — Tokenizer dari kelas CLIPTokenizer. - scheduler (
UnCLIPScheduler) — Penjadwal yang digunakan bersamaprioruntuk menghasilkan embedding gambar.
Pipeline untuk menghasilkan prior gambar untuk Kandinsky
Model ini mewarisi dari DiffusionPipeline. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua pipeline (seperti mengunduh atau menyimpan, menjalankan pada perangkat tertentu, dll.)
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneguidance_scale: float = 4.0output_type: str | None = 'pt'return_dict: bool = True ) → KandinskyPriorPipelineOutput or tuple
Parameter
- prompt (
strataulist[str]) — Prompt atau kumpulan prompt untuk mengarahkan generasi gambar. - negative_prompt (
strataulist[str], opsional) — Prompt atau prompt-prompt yang tidak digunakan untuk mengarahkan generasi gambar. Diabaikan ketika tidak menggunakan guidance (yaitu, diabaikan jikaguidance_scalekurang dari1). - num_images_per_prompt (
int, opsional, default 1) — Jumlah gambar yang akan dihasilkan per prompt. - num_inference_steps (
int, opsional, default 25) — Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan gambar dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat. - generator (
torch.Generatorataulist[torch.Generator], opsional) — Satu atau daftar generator torch untuk membuat proses generasi menjadi deterministik. - latents (
torch.Tensor, opsional) — Latents berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi gambar. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor latents akan dibuat dengan pengambilan sampel menggunakangeneratoracak yang diberikan. - guidance_scale (
float, opsional, default 4.0) — Skala panduan seperti yang didefinisikan dalam Classifier-Free Diffusion Guidance.guidance_scaledidefinisikan sebagaiwdari persamaan 2. dari Imagen Paper. Skala panduan diaktifkan dengan mengaturguidance_scale > 1. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait denganpromptteks, biasanya dengan mengorbankan kualitas gambar yang lebih rendah. - output_type (
str, opsional, default"pt") — Format output dari generate image. Pilih antara:"np"(np.array) atau"pt"(torch.Tensor). - return_dict (
bool, opsional, defaultnyaTrue) — Apakah akan mengembalikan ImagePipelineOutput alih-alih tuple biasa.
Mengembalikan
KandinskyPriorPipelineOutput atau tuple
Fungsi yang dipanggil saat memanggil pipeline untuk generasi.
Contoh:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
interpolate
< source >( images_and_prompts: listweights: listnum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Nonenegative_prior_prompt: str | None = Nonenegative_prompt: str = ''guidance_scale: float = 4.0device = None ) → KandinskyPriorPipelineOutput or tuple
Parameter
- images_and_prompts (
list[str | PIL.Image.Image | torch.Tensor]) — daftar prompt dan gambar untuk memandu pembuatan gambar. - weights — (
list[float]): daftar bobot untuk setiap kondisi diimages_and_prompts - num_images_per_prompt (
int, opsional, default 1) — Jumlah gambar yang akan dihasilkan per prompt. - num_inference_steps (
int, opsional, default 25) — Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan gambar dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat. - generator (
torch.Generatorataulist[torch.Generator], opsional) — Satu atau daftar generator torch untuk membuat proses generasi menjadi deterministik. - latents (
torch.Tensor, opsional) — Latents berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi gambar. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor latents akan dibuat dengan pengambilan sampel menggunakangeneratoracak yang diberikan. - negative_prior_prompt (
str, opsional) — Prompt yang tidak digunakan untuk memandu proses difusi prior. Diabaikan saat tidak menggunakan guidance (yaitu, diabaikan jikaguidance_scalekurang dari1). - negative_prompt (
strataulist[str], opsional) — Prompt yang tidak digunakan untuk mengarahkan generasi gambar. Diabaikan saat tidak menggunakan guidance (yaitu, diabaikan jikaguidance_scalekurang dari1). - guidance_scale (
float, opsional, default 4.0) — Skala panduan seperti yang didefinisikan dalam Classifier-Free Diffusion Guidance.guidance_scaledidefinisikan sebagaiwdari persamaan 2. dari Imagen Paper. Skala panduan diaktifkan dengan mengaturguidance_scale > 1. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait denganpromptteks, biasanya dengan mengorbankan kualitas gambar yang lebih rendah.
Mengembalikan
KandinskyPriorPipelineOutput atau tuple
Fungsi yang dipanggil saat menggunakan pipeline sebelumnya untuk interpolasi.
Contoh:
>>> from diffusers import KandinskyPriorPipeline, KandinskyPipeline
>>> from diffusers.utils import load_image
>>> import PIL

>>> import torch
>>> from torchvision import transforms

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> img1 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png"
... )

>>> img2 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/starry_night.jpeg"
... )

>>> images_texts = ["a cat", img1, img2]
>>> weights = [0.3, 0.3, 0.4]
>>> image_emb, zero_image_emb = pipe_prior.interpolate(images_texts, weights)

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16)
>>> pipe.to("cuda")

>>> image = pipe(
...     "",
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=150,
... ).images[0]

>>> image.save("starry_cat.png")
KandinskyPipeline
kelas diffusers.KandinskyPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModel )
Parameter
- text_encoder (
MultilingualCLIP) — Text-encoder yang dibekukan. - tokenizer (
XLMRobertaTokenizer) — Tokenizer dari kelas - scheduler (
DDIMScheduler|DDPMScheduler) — Scheduler yang digunakan bersamaunetuntuk menghasilkan latens gambar. - unet (UNet2DConditionModel) — Arsitektur U-Net bersyarat untuk mendenoising embedding gambar.
- movq (VQModel) — MoVQ Decoder untuk menghasilkan gambar dari latents.
Pipeline untuk generasi teks-ke-gambar menggunakan Kandinsky
Model ini mewarisi dari DiffusionPipeline. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua pipeline (seperti mengunduh atau menyimpan, menjalankan pada perangkat tertentu, dll.)
__call__
< source >( prompt: str | list[str]image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parameter
- prompt (
strataulist[str]) — Prompt atau kumpulan prompt untuk mengarahkan generasi gambar. - image_embeds (
torch.Tensorataulist[torch.Tensor]) — Embedding gambar clip untuk prompt teks, yang akan digunakan untuk mengondisikan generasi gambar. - negative_image_embeds (
torch.Tensorataulist[torch.Tensor]) — Embedding gambar clip untuk prompt teks negatif, akan digunakan untuk mengondisikan generasi gambar. - negative_prompt (
strataulist[str], opsional) — Prompt atau prompt-prompt yang tidak digunakan untuk mengarahkan generasi gambar. Diabaikan ketika tidak menggunakan guidance (yaitu, diabaikan jikaguidance_scalekurang dari1). - height (
int, opsional, default 512) — Tinggi gambar yang dihasilkan dalam piksel. - width (
int, opsional, default 512) — Lebar gambar yang dihasilkan dalam piksel. - num_inference_steps (
int, opsional, default 100) — Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan gambar dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat. - guidance_scale (
float, opsional, default 4.0) — Skala panduan seperti yang didefinisikan dalam Classifier-Free Diffusion Guidance.guidance_scaledidefinisikan sebagaiwdari persamaan 2. dari Imagen Paper. Skala panduan diaktifkan dengan mengaturguidance_scale > 1. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait denganpromptteks, biasanya dengan mengorbankan kualitas gambar yang lebih rendah. - num_images_per_prompt (
int, opsional, default 1) — Jumlah gambar yang akan dihasilkan per prompt. - generator (
torch.Generatorataulist[torch.Generator], opsional) — Satu atau daftar generator torch untuk membuat proses generasi menjadi deterministik. - latents (
torch.Tensor, opsional) — Latents berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi gambar. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor latents akan dibuat dengan pengambilan sampel menggunakangeneratoracak yang diberikan. - output_type (
str, opsional, default"pil") — Format output dari generate image. Pilih antara:"pil"(PIL.Image.Image),"np"(np.array) atau"pt"(torch.Tensor). - callback (
Callable, opsional) — Fungsi yang dipanggil setiapcallback_stepslangkah selama inferensi. Fungsi ini dipanggil dengan argumen berikut:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opsional, default 1) — Frekuensi pemanggilan fungsicallback. Jika tidak ditentukan, callback dipanggil pada setiap langkah. - return_dict (
bool, opsional, defaultnyaTrue) — Apakah akan mengembalikan ImagePipelineOutput alih-alih tuple biasa.
Mengembalikan
ImagePipelineOutput atau tuple
Fungsi yang dipanggil saat memanggil pipeline untuk generasi.
Contoh:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/Kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
KandinskyCombinedPipeline
kelas diffusers.KandinskyCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Parameter
- text_encoder (
MultilingualCLIP) — Text-encoder yang dibekukan. - tokenizer (
XLMRobertaTokenizer) — Tokenizer dari kelas - scheduler (
DDIMScheduler|DDPMScheduler) — Scheduler yang digunakan bersamaunetuntuk menghasilkan latens gambar. - unet (UNet2DConditionModel) — Arsitektur U-Net bersyarat untuk mendenoising embedding gambar.
- movq (VQModel) — MoVQ Decoder untuk menghasilkan gambar dari latents.
- prior_prior (PriorTransformer) — prior unCLIP kanonik untuk mengaproksimasi embedding gambar dari embedding teks.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Image-encoder yang dibekukan. - prior_text_encoder (
CLIPTextModelWithProjection) — Text-encoder yang dibekukan. - prior_tokenizer (
CLIPTokenizer) — Tokenizer dari kelas CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — Scheduler yang digunakan bersamaprioruntuk menghasilkan embedding gambar.
Pipeline Gabungan untuk pembuatan teks-ke-gambar menggunakan Kandinsky
Model ini mewarisi dari DiffusionPipeline. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua pipeline (seperti mengunduh atau menyimpan, menjalankan pada perangkat tertentu, dll.)
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parameter
- prompt (
strataulist[str]) — Prompt atau kumpulan prompt untuk mengarahkan generasi gambar. - negative_prompt (
strataulist[str], opsional) — Prompt atau prompt-prompt yang tidak digunakan untuk mengarahkan generasi gambar. Diabaikan ketika tidak menggunakan guidance (yaitu, diabaikan jikaguidance_scalekurang dari1). - num_images_per_prompt (
int, opsional, default 1) — Jumlah gambar yang akan dihasilkan per prompt. - num_inference_steps (
int, opsional, default 100) — Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan gambar dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat. - height (
int, opsional, default 512) — Tinggi gambar yang dihasilkan dalam piksel. - width (
int, opsional, default 512) — Lebar gambar yang dihasilkan dalam piksel. - prior_guidance_scale (
float, opsional, default 4.0) — Skala panduan seperti yang didefinisikan dalam Classifier-Free Diffusion Guidance.guidance_scaledidefinisikan sebagaiwdari persamaan 2. dari Imagen Paper. Skala panduan diaktifkan dengan mengaturguidance_scale > 1. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait denganpromptteks, biasanya dengan mengorbankan kualitas gambar yang lebih rendah. - prior_num_inference_steps (
int, opsional, default 100) — Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan gambar dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat. - guidance_scale (
float, opsional, default 4.0) — Skala panduan seperti yang didefinisikan dalam Classifier-Free Diffusion Guidance.guidance_scaledidefinisikan sebagaiwdari persamaan 2. dari Imagen Paper. Skala panduan diaktifkan dengan mengaturguidance_scale > 1. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait denganpromptteks, biasanya dengan mengorbankan kualitas gambar yang lebih rendah. - generator (
torch.Generatorataulist[torch.Generator], opsional) — Satu atau daftar generator torch untuk membuat proses generasi menjadi deterministik. - latents (
torch.Tensor, opsional) — Latents berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi gambar. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor latents akan dibuat dengan pengambilan sampel menggunakangeneratoracak yang diberikan. - output_type (
str, opsional, default"pil") — Format output dari generate image. Pilih antara:"pil"(PIL.Image.Image),"np"(np.array) atau"pt"(torch.Tensor). - callback (
Callable, opsional) — Fungsi yang dipanggil setiapcallback_stepslangkah selama inferensi. Fungsi ini dipanggil dengan argumen berikut:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opsional, default 1) — Frekuensi pemanggilan fungsicallback. Jika tidak ditentukan, callback dipanggil pada setiap langkah. - return_dict (
bool, opsional, defaultnyaTrue) — Apakah akan mengembalikan ImagePipelineOutput alih-alih tuple biasa.
Mengembalikan
ImagePipelineOutput atau tuple
Fungsi yang dipanggil saat memanggil pipeline untuk generasi.
Contoh:
from diffusers import AutoPipelineForText2Image
import torch

pipe = AutoPipelineForText2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A lion in galaxies, spirals, nebulae, stars, smoke, iridescent, intricate detail, octane render, 8k"

image = pipe(prompt=prompt, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Membongkar semua model (unet, text_encoder, vae, dan safety checker state dicts) ke CPU menggunakan 🤗
Accelerate, sehingga penggunaan memori berkurang secara signifikan. Model dipindahkan ke torch.device('meta') dan dimuat ke
GPU hanya ketika metode forward dari submodul spesifiknya dipanggil. Pembongkaran terjadi berdasarkan submodul.
Penghematan memori lebih tinggi daripada menggunakan enable_model_cpu_offload, tetapi kinerjanya lebih rendah.
KandinskyImg2ImgPipeline
kelas diffusers.KandinskyImg2ImgPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
Parameter
- text_encoder (
MultilingualCLIP) — Text-encoder yang dibekukan. - tokenizer (
XLMRobertaTokenizer) — Tokenizer dari kelas - scheduler (DDIMScheduler) —
Scheduler yang digunakan bersama
unetuntuk menghasilkan latens gambar. - unet (UNet2DConditionModel) — Arsitektur U-Net bersyarat untuk mendenoising embedding gambar.
- movq (VQModel) — Encoder dan decoder gambar MoVQ
Pipeline untuk generasi gambar-ke-gambar menggunakan Kandinsky
Model ini mewarisi dari DiffusionPipeline. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua pipeline (seperti mengunduh atau menyimpan, menjalankan pada perangkat tertentu, dll.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100strength: float = 0.3guidance_scale: float = 7.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parameter
- prompt (
strataulist[str]) — Prompt atau kumpulan prompt untuk mengarahkan generasi gambar. - image (
torch.Tensor,PIL.Image.Image) —Image, atau tensor yang mewakili batch gambar, yang akan digunakan sebagai titik awal untuk proses. - image_embeds (
torch.Tensorataulist[torch.Tensor]) — Embedding gambar clip untuk prompt teks, yang akan digunakan untuk mengondisikan generasi gambar. - negative_image_embeds (
torch.Tensorataulist[torch.Tensor]) — Embedding gambar clip untuk prompt teks negatif, akan digunakan untuk mengondisikan generasi gambar. - negative_prompt (
strataulist[str], opsional) — Prompt atau prompt-prompt yang tidak digunakan untuk mengarahkan generasi gambar. Diabaikan ketika tidak menggunakan guidance (yaitu, diabaikan jikaguidance_scalekurang dari1). - height (
int, opsional, default 512) — Tinggi gambar yang dihasilkan dalam piksel. - width (
int, opsional, default 512) — Lebar gambar yang dihasilkan dalam piksel. - num_inference_steps (
int, opsional, default 100) — Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan gambar dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat. - strength (
float, opsional, default 0.3) — Secara konseptual, menunjukkan seberapa besar transformasi yang diterapkan padaimagereferensi. Nilainya harus berada di antara 0 dan 1.imageakan digunakan sebagai titik awal, dengan semakin banyak noise yang ditambahkan seiring dengan semakin besarnya nilaistrength. Jumlah langkah denoising bergantung pada jumlah noise yang awalnya ditambahkan. Ketikastrengthbernilai 1, noise yang ditambahkan akan maksimal dan proses denoising akan berjalan untuk jumlah iterasi penuh yang ditentukan dalamnum_inference_steps. Dengan demikian, nilai 1 pada dasarnya mengabaikanimage. - guidance_scale (
float, opsional, default 4.0) — Skala panduan seperti yang didefinisikan dalam Classifier-Free Diffusion Guidance.guidance_scaledidefinisikan sebagaiwdari persamaan 2. dari Imagen Paper. Skala panduan diaktifkan dengan mengaturguidance_scale > 1. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait denganpromptteks, biasanya dengan mengorbankan kualitas gambar yang lebih rendah. - num_images_per_prompt (
int, opsional, default 1) — Jumlah gambar yang akan dihasilkan per prompt. - generator (
torch.Generatorataulist[torch.Generator], opsional) — Satu atau daftar generator torch untuk membuat proses generasi menjadi deterministik. - output_type (
str, opsional, default"pil") — Format output dari generate image. Pilih antara:"pil"(PIL.Image.Image),"np"(np.array) atau"pt"(torch.Tensor). - callback (
Callable, opsional) — Fungsi yang dipanggil setiapcallback_stepslangkah selama inferensi. Fungsi ini dipanggil dengan argumen berikut:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opsional, default 1) — Frekuensi pemanggilan fungsicallback. Jika tidak ditentukan, callback dipanggil pada setiap langkah. - return_dict (
bool, opsional, defaultnyaTrue) — Apakah akan mengembalikan ImagePipelineOutput alih-alih tuple biasa.
Mengembalikan
ImagePipelineOutput atau tuple
Fungsi yang dipanggil saat memanggil pipeline untuk generasi.
Contoh:
>>> from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "A red cartoon frog, 4k"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyImg2ImgPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/frog.png"
... )

>>> image = pipe(
...     prompt,
...     image=init_image,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
...     strength=0.2,
... ).images

>>> image[0].save("red_frog.png")
KandinskyImg2ImgCombinedPipeline
kelas diffusers.KandinskyImg2ImgCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Parameter
- text_encoder (
MultilingualCLIP) — Text-encoder yang dibekukan. - tokenizer (
XLMRobertaTokenizer) — Tokenizer dari kelas - scheduler (
DDIMScheduler|DDPMScheduler) — Scheduler yang digunakan bersamaunetuntuk menghasilkan latens gambar. - unet (UNet2DConditionModel) — Arsitektur U-Net bersyarat untuk mendenoising embedding gambar.
- movq (VQModel) — MoVQ Decoder untuk menghasilkan gambar dari latents.
- prior_prior (PriorTransformer) — prior unCLIP kanonik untuk mengaproksimasi embedding gambar dari embedding teks.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Image-encoder yang dibekukan. - prior_text_encoder (
CLIPTextModelWithProjection) — Text-encoder yang dibekukan. - prior_tokenizer (
CLIPTokenizer) — Tokenizer dari kelas CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — Scheduler yang digunakan bersamaprioruntuk menghasilkan embedding gambar.
Pipeline Gabungan untuk generasi gambar-ke-gambar menggunakan Kandinsky
Model ini mewarisi dari DiffusionPipeline. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua pipeline (seperti mengunduh atau menyimpan, menjalankan pada perangkat tertentu, dll.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1strength: float = 0.3height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parameter
- prompt (
strataulist[str]) — Prompt atau kumpulan prompt untuk mengarahkan generasi gambar. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image], ataulist[np.ndarray]) —Image, atau tensor yang mewakili batch gambar, yang akan digunakan sebagai titik awal untuk proses. Dapat juga menerima latents gambar sebagaiimage; jika latents diteruskan secara langsung, latents tersebut tidak akan di-encode lagi. - negative_prompt (
strataulist[str], opsional) — Prompt atau prompt-prompt yang tidak digunakan untuk mengarahkan generasi gambar. Diabaikan ketika tidak menggunakan guidance (yaitu, diabaikan jikaguidance_scalekurang dari1). - num_images_per_prompt (
int, opsional, default 1) — Jumlah gambar yang akan dihasilkan per prompt. - num_inference_steps (
int, opsional, default 100) — Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan gambar dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat. - height (
int, opsional, default 512) — Tinggi gambar yang dihasilkan dalam piksel. - width (
int, opsional, default 512) — Lebar gambar yang dihasilkan dalam piksel. - strength (
float, opsional, default 0.3) — Secara konseptual, menunjukkan seberapa besar transformasi yang diterapkan padaimagereferensi. Nilainya harus berada di antara 0 dan 1.imageakan digunakan sebagai titik awal, dengan semakin banyak noise yang ditambahkan seiring dengan semakin besarnya nilaistrength. Jumlah langkah denoising bergantung pada jumlah noise yang awalnya ditambahkan. Ketikastrengthbernilai 1, noise yang ditambahkan akan maksimal dan proses denoising akan berjalan untuk jumlah iterasi penuh yang ditentukan dalamnum_inference_steps. Dengan demikian, nilai 1 pada dasarnya mengabaikanimage. - prior_guidance_scale (
float, opsional, default 4.0) — Skala panduan seperti yang didefinisikan dalam Classifier-Free Diffusion Guidance.guidance_scaledidefinisikan sebagaiwdari persamaan 2. dari Imagen Paper. Skala panduan diaktifkan dengan mengaturguidance_scale > 1. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait denganpromptteks, biasanya dengan mengorbankan kualitas gambar yang lebih rendah. - prior_num_inference_steps (
int, opsional, default 100) — Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan gambar dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat. - guidance_scale (
float, opsional, default 4.0) — Skala panduan seperti yang didefinisikan dalam Classifier-Free Diffusion Guidance.guidance_scaledidefinisikan sebagaiwdari persamaan 2. dari Imagen Paper. Skala panduan diaktifkan dengan mengaturguidance_scale > 1. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait denganpromptteks, biasanya dengan mengorbankan kualitas gambar yang lebih rendah. - generator (
torch.Generatorataulist[torch.Generator], opsional) — Satu atau daftar generator torch untuk membuat proses generasi menjadi deterministik. - latents (
torch.Tensor, opsional) — Latents berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi gambar. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor latents akan dibuat dengan pengambilan sampel menggunakangeneratoracak yang diberikan. - output_type (
str, opsional, default"pil") — Format output dari generate image. Pilih antara:"pil"(PIL.Image.Image),"np"(np.array) atau"pt"(torch.Tensor). - callback (
Callable, opsional) — Fungsi yang dipanggil setiapcallback_stepslangkah selama inferensi. Fungsi ini dipanggil dengan argumen berikut:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opsional, default 1) — Frekuensi pemanggilan fungsicallback. Jika tidak ditentukan, callback dipanggil pada setiap langkah. - return_dict (
bool, opsional, defaultnyaTrue) — Apakah akan mengembalikan ImagePipelineOutput alih-alih tuple biasa.
Mengembalikan
ImagePipelineOutput atau tuple
Fungsi yang dipanggil saat memanggil pipeline untuk generasi.
Contoh:
from diffusers import AutoPipelineForImage2Image
import torch
import requests
from io import BytesIO
from PIL import Image
import os

pipe = AutoPipelineForImage2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"

response = requests.get(url)
image = Image.open(BytesIO(response.content)).convert("RGB")
image.thumbnail((768, 768))

image = pipe(prompt=prompt, image=original_image, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Offloads all models to CPU using accelerate, significantly reducing memory usage. When called, unet,
text_encoder, vae and safety checker have their state dicts saved to CPU and then are moved to a torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.
KandinskyInpaintPipeline
kelas diffusers.KandinskyInpaintPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
Parameter
- text_encoder (
MultilingualCLIP) — Text-encoder yang dibekukan. - tokenizer (
XLMRobertaTokenizer) — Tokenizer dari kelas - scheduler (DDIMScheduler) —
Scheduler yang digunakan bersama
unetuntuk menghasilkan latens gambar. - unet (UNet2DConditionModel) — Arsitektur U-Net bersyarat untuk mendenoising embedding gambar.
- movq (VQModel) — Encoder dan decoder gambar MoVQ
Pipeline untuk inpainting gambar yang dipandu teks menggunakan Kandinsky2.1
Model ini mewarisi dari DiffusionPipeline. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua pipeline (seperti mengunduh atau menyimpan, menjalankan pada perangkat tertentu, dll.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, PIL.Image.Image]mask_image: typing.Union[PIL.Image.Image, torch.Tensor, numpy.ndarray]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parameter
- prompt (
strataulist[str]) — Prompt atau kumpulan prompt untuk mengarahkan generasi gambar. - image (
torch.Tensor,PIL.Image.Imageataunp.ndarray) —Image, atau tensor yang mewakili batch gambar, yang akan digunakan sebagai titik awal untuk proses. - mask_image (
PIL.Image.Image,torch.Tensorataunp.ndarray) —Image, atau tensor yang mewakili batch gambar, untuk memberi mask padaimage. Piksel putih pada mask akan digambar ulang, sedangkan piksel hitam akan dipertahankan. Anda hanya dapat meneruskan tensor pytorch sebagai mask jika gambar yang Anda teruskan adalah tensor pytorch, dan tensor tersebut harus berisi satu saluran warna (L) alih-alih 3, sehingga bentuk yang diharapkan adalah(B, 1, H, W,),(B, H, W),(1, H, W)atau(H, W)Jika gambar adalah gambar PIL atau array numpy, mask juga harus berupa gambar PIL atau array numpy. Jika berupa gambar PIL, gambar tersebut akan dikonversi menjadi satu saluran (luminance) sebelum digunakan. Jika berupa array numpy, bentuk yang diharapkan adalah(H, W). - image_embeds (
torch.Tensorataulist[torch.Tensor]) — Embedding gambar clip untuk prompt teks, yang akan digunakan untuk mengondisikan generasi gambar. - negative_image_embeds (
torch.Tensorataulist[torch.Tensor]) — Embedding gambar clip untuk prompt teks negatif, akan digunakan untuk mengondisikan generasi gambar. - negative_prompt (
strataulist[str], opsional) — Prompt atau prompt-prompt yang tidak digunakan untuk mengarahkan generasi gambar. Diabaikan ketika tidak menggunakan guidance (yaitu, diabaikan jikaguidance_scalekurang dari1). - height (
int, opsional, default 512) — Tinggi gambar yang dihasilkan dalam piksel. - width (
int, opsional, default 512) — Lebar gambar yang dihasilkan dalam piksel. - num_inference_steps (
int, opsional, default 100) — Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan gambar dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat. - guidance_scale (
float, opsional, default 4.0) — Skala panduan seperti yang didefinisikan dalam Classifier-Free Diffusion Guidance.guidance_scaledidefinisikan sebagaiwdari persamaan 2. dari Imagen Paper. Skala panduan diaktifkan dengan mengaturguidance_scale > 1. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait denganpromptteks, biasanya dengan mengorbankan kualitas gambar yang lebih rendah. - num_images_per_prompt (
int, opsional, default 1) — Jumlah gambar yang akan dihasilkan per prompt. - generator (
torch.Generatorataulist[torch.Generator], opsional) — Satu atau daftar generator torch untuk membuat proses generasi menjadi deterministik. - latents (
torch.Tensor, opsional) — Latents berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi gambar. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor latents akan dibuat dengan pengambilan sampel menggunakangeneratoracak yang diberikan. - output_type (
str, opsional, default"pil") — Format output dari generate image. Pilih antara:"pil"(PIL.Image.Image),"np"(np.array) atau"pt"(torch.Tensor). - callback (
Callable, opsional) — Fungsi yang dipanggil setiapcallback_stepslangkah selama inferensi. Fungsi ini dipanggil dengan argumen berikut:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opsional, default 1) — Frekuensi pemanggilan fungsicallback. Jika tidak ditentukan, callback dipanggil pada setiap langkah. - return_dict (
bool, opsional, defaultnyaTrue) — Apakah akan mengembalikan ImagePipelineOutput alih-alih tuple biasa.
Mengembalikan
ImagePipelineOutput atau tuple
Fungsi yang dipanggil saat memanggil pipeline untuk generasi.
Contoh:
>>> from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch
>>> import numpy as np

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "a hat"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyInpaintPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png"
... )

>>> mask = np.zeros((768, 768), dtype=np.float32)
>>> mask[:250, 250:-250] = 1

>>> out = pipe(
...     prompt,
...     image=init_image,
...     mask_image=mask,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=50,
... )

>>> image = out.images[0]
>>> image.save("cat_with_hat.png")
KandinskyInpaintCombinedPipeline
kelas diffusers.KandinskyInpaintCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Parameter
- text_encoder (
MultilingualCLIP) — Text-encoder yang dibekukan. - tokenizer (
XLMRobertaTokenizer) — Tokenizer dari kelas - scheduler (
DDIMScheduler|DDPMScheduler) — Scheduler yang digunakan bersamaunetuntuk menghasilkan latens gambar. - unet (UNet2DConditionModel) — Arsitektur U-Net bersyarat untuk mendenoising embedding gambar.
- movq (VQModel) — MoVQ Decoder untuk menghasilkan gambar dari latents.
- prior_prior (PriorTransformer) — prior unCLIP kanonik untuk mengaproksimasi embedding gambar dari embedding teks.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Image-encoder yang dibekukan. - prior_text_encoder (
CLIPTextModelWithProjection) — Text-encoder yang dibekukan. - prior_tokenizer (
CLIPTokenizer) — Tokenizer dari kelas CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — Scheduler yang digunakan bersamaprioruntuk menghasilkan embedding gambar.
Pipeline Gabungan untuk generasi menggunakan Kandinsky
Model ini mewarisi dari DiffusionPipeline. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua pipeline (seperti mengunduh atau menyimpan, menjalankan pada perangkat tertentu, dll.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]mask_image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parameter
- prompt (
strataulist[str]) — Prompt atau kumpulan prompt untuk mengarahkan generasi gambar. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image], ataulist[np.ndarray]) —Image, atau tensor yang mewakili batch gambar, yang akan digunakan sebagai titik awal untuk proses. Dapat juga menerima latents gambar sebagaiimage; jika latents diteruskan secara langsung, latents tersebut tidak akan di-encode lagi. - mask_image (
np.array) — Tensor yang mewakili batch gambar, untuk memberi mask padaimage. Piksel putih pada mask akan diwarnai ulang, sedangkan piksel hitam akan dipertahankan. Jikamask_imageadalah gambar PIL, gambar tersebut akan dikonversi menjadi satu saluran (luminance) sebelum digunakan. Jika berupa tensor, tensor tersebut harus berisi satu saluran warna (L) alih-alih 3, sehingga bentuk yang diharapkan adalah(B, H, W, 1). - negative_prompt (
strataulist[str], opsional) — Prompt atau prompt-prompt yang tidak digunakan untuk mengarahkan generasi gambar. Diabaikan ketika tidak menggunakan guidance (yaitu, diabaikan jikaguidance_scalekurang dari1). - num_images_per_prompt (
int, opsional, default 1) — Jumlah gambar yang akan dihasilkan per prompt. - num_inference_steps (
int, opsional, default 100) — Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan gambar dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat. - height (
int, opsional, default 512) — Tinggi gambar yang dihasilkan dalam piksel. - width (
int, opsional, default 512) — Lebar gambar yang dihasilkan dalam piksel. - prior_guidance_scale (
float, opsional, default 4.0) — Skala panduan seperti yang didefinisikan dalam Classifier-Free Diffusion Guidance.guidance_scaledidefinisikan sebagaiwdari persamaan 2. dari Imagen Paper. Skala panduan diaktifkan dengan mengaturguidance_scale > 1. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait denganpromptteks, biasanya dengan mengorbankan kualitas gambar yang lebih rendah. - prior_num_inference_steps (
int, opsional, default 100) — Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan gambar dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat. - guidance_scale (
float, opsional, default 4.0) — Skala panduan seperti yang didefinisikan dalam Classifier-Free Diffusion Guidance.guidance_scaledidefinisikan sebagaiwdari persamaan 2. dari Imagen Paper. Skala panduan diaktifkan dengan mengaturguidance_scale > 1. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait denganpromptteks, biasanya dengan mengorbankan kualitas gambar yang lebih rendah. - generator (
torch.Generatorataulist[torch.Generator], opsional) — Satu atau daftar generator torch untuk membuat proses generasi menjadi deterministik. - latents (
torch.Tensor, opsional) — Latents berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi gambar. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor latents akan dibuat dengan pengambilan sampel menggunakangeneratoracak yang diberikan. - output_type (
str, opsional, default"pil") — Format output dari generate image. Pilih antara:"pil"(PIL.Image.Image),"np"(np.array) atau"pt"(torch.Tensor). - callback (
Callable, opsional) — Fungsi yang dipanggil setiapcallback_stepslangkah selama inferensi. Fungsi ini dipanggil dengan argumen berikut:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opsional, default 1) — Frekuensi pemanggilan fungsicallback. Jika tidak ditentukan, callback dipanggil pada setiap langkah. - return_dict (
bool, opsional, defaultnyaTrue) — Apakah akan mengembalikan ImagePipelineOutput alih-alih tuple biasa.
Mengembalikan
ImagePipelineOutput atau tuple
Fungsi yang dipanggil saat memanggil pipeline untuk generasi.
Contoh:
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image
import torch
import numpy as np

pipe = AutoPipelineForInpainting.from_pretrained(
    "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

original_image = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png"
)

mask = np.zeros((768, 768), dtype=np.float32)
# Let's mask out an area above the cat's head
mask[:250, 250:-250] = 1

image = pipe(prompt=prompt, image=original_image, mask_image=mask, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Offloads all models to CPU using accelerate, significantly reducing memory usage. When called, unet,
text_encoder, vae and safety checker have their state dicts saved to CPU and then are moved to a torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.