
LeRobot documentation
LIBERO
LIBERO
The commands below run the simulator locally. To keep its dependencies away from your policy's, serve it instead with `lerobot-env-server --config_path=docker/sim/configs/libero.yaml --sim.task=--docker=true`, where ` ` is the command's `--env.task`, and add `--env.server.endpoint=tcp/127.0.0.1:7448` to the command. A server runs the task it was started with (see [Simulation: local or served](./simulation)).
LIBERO는 평생 로봇 학습을 연구하기 위해 설계된 벤치마크입니다. 이는 로봇이 단순히 한 번 사전 학습되는 것이 아니라, 사용자와 함께 시간이 지남에 따라 지속적으로 학습하고 적응해야 한다는 개념을 기반으로 합니다. LIBERO는 지식 전이에 초점을 맞춘 표준화된 조작 작업 세트를 제공합니다. 즉, 로봇이 이미 학습한 내용을 새로운 상황에 얼마나 잘 적용할 수 있는지를 평가합니다. LIBERO를 통해 평가하면 서로 다른 알고리즘을 공정하게 비교할 수 있으며, 연구자들은 서로의 연구를 기반으로 발전시킬 수 있습니다.
- 논문: Benchmarking Knowledge Transfer for Lifelong Robot Learning
- GitHub: Lifelong-Robot-Learning/LIBERO
- 프로젝트 웹사이트: libero-project.github.io
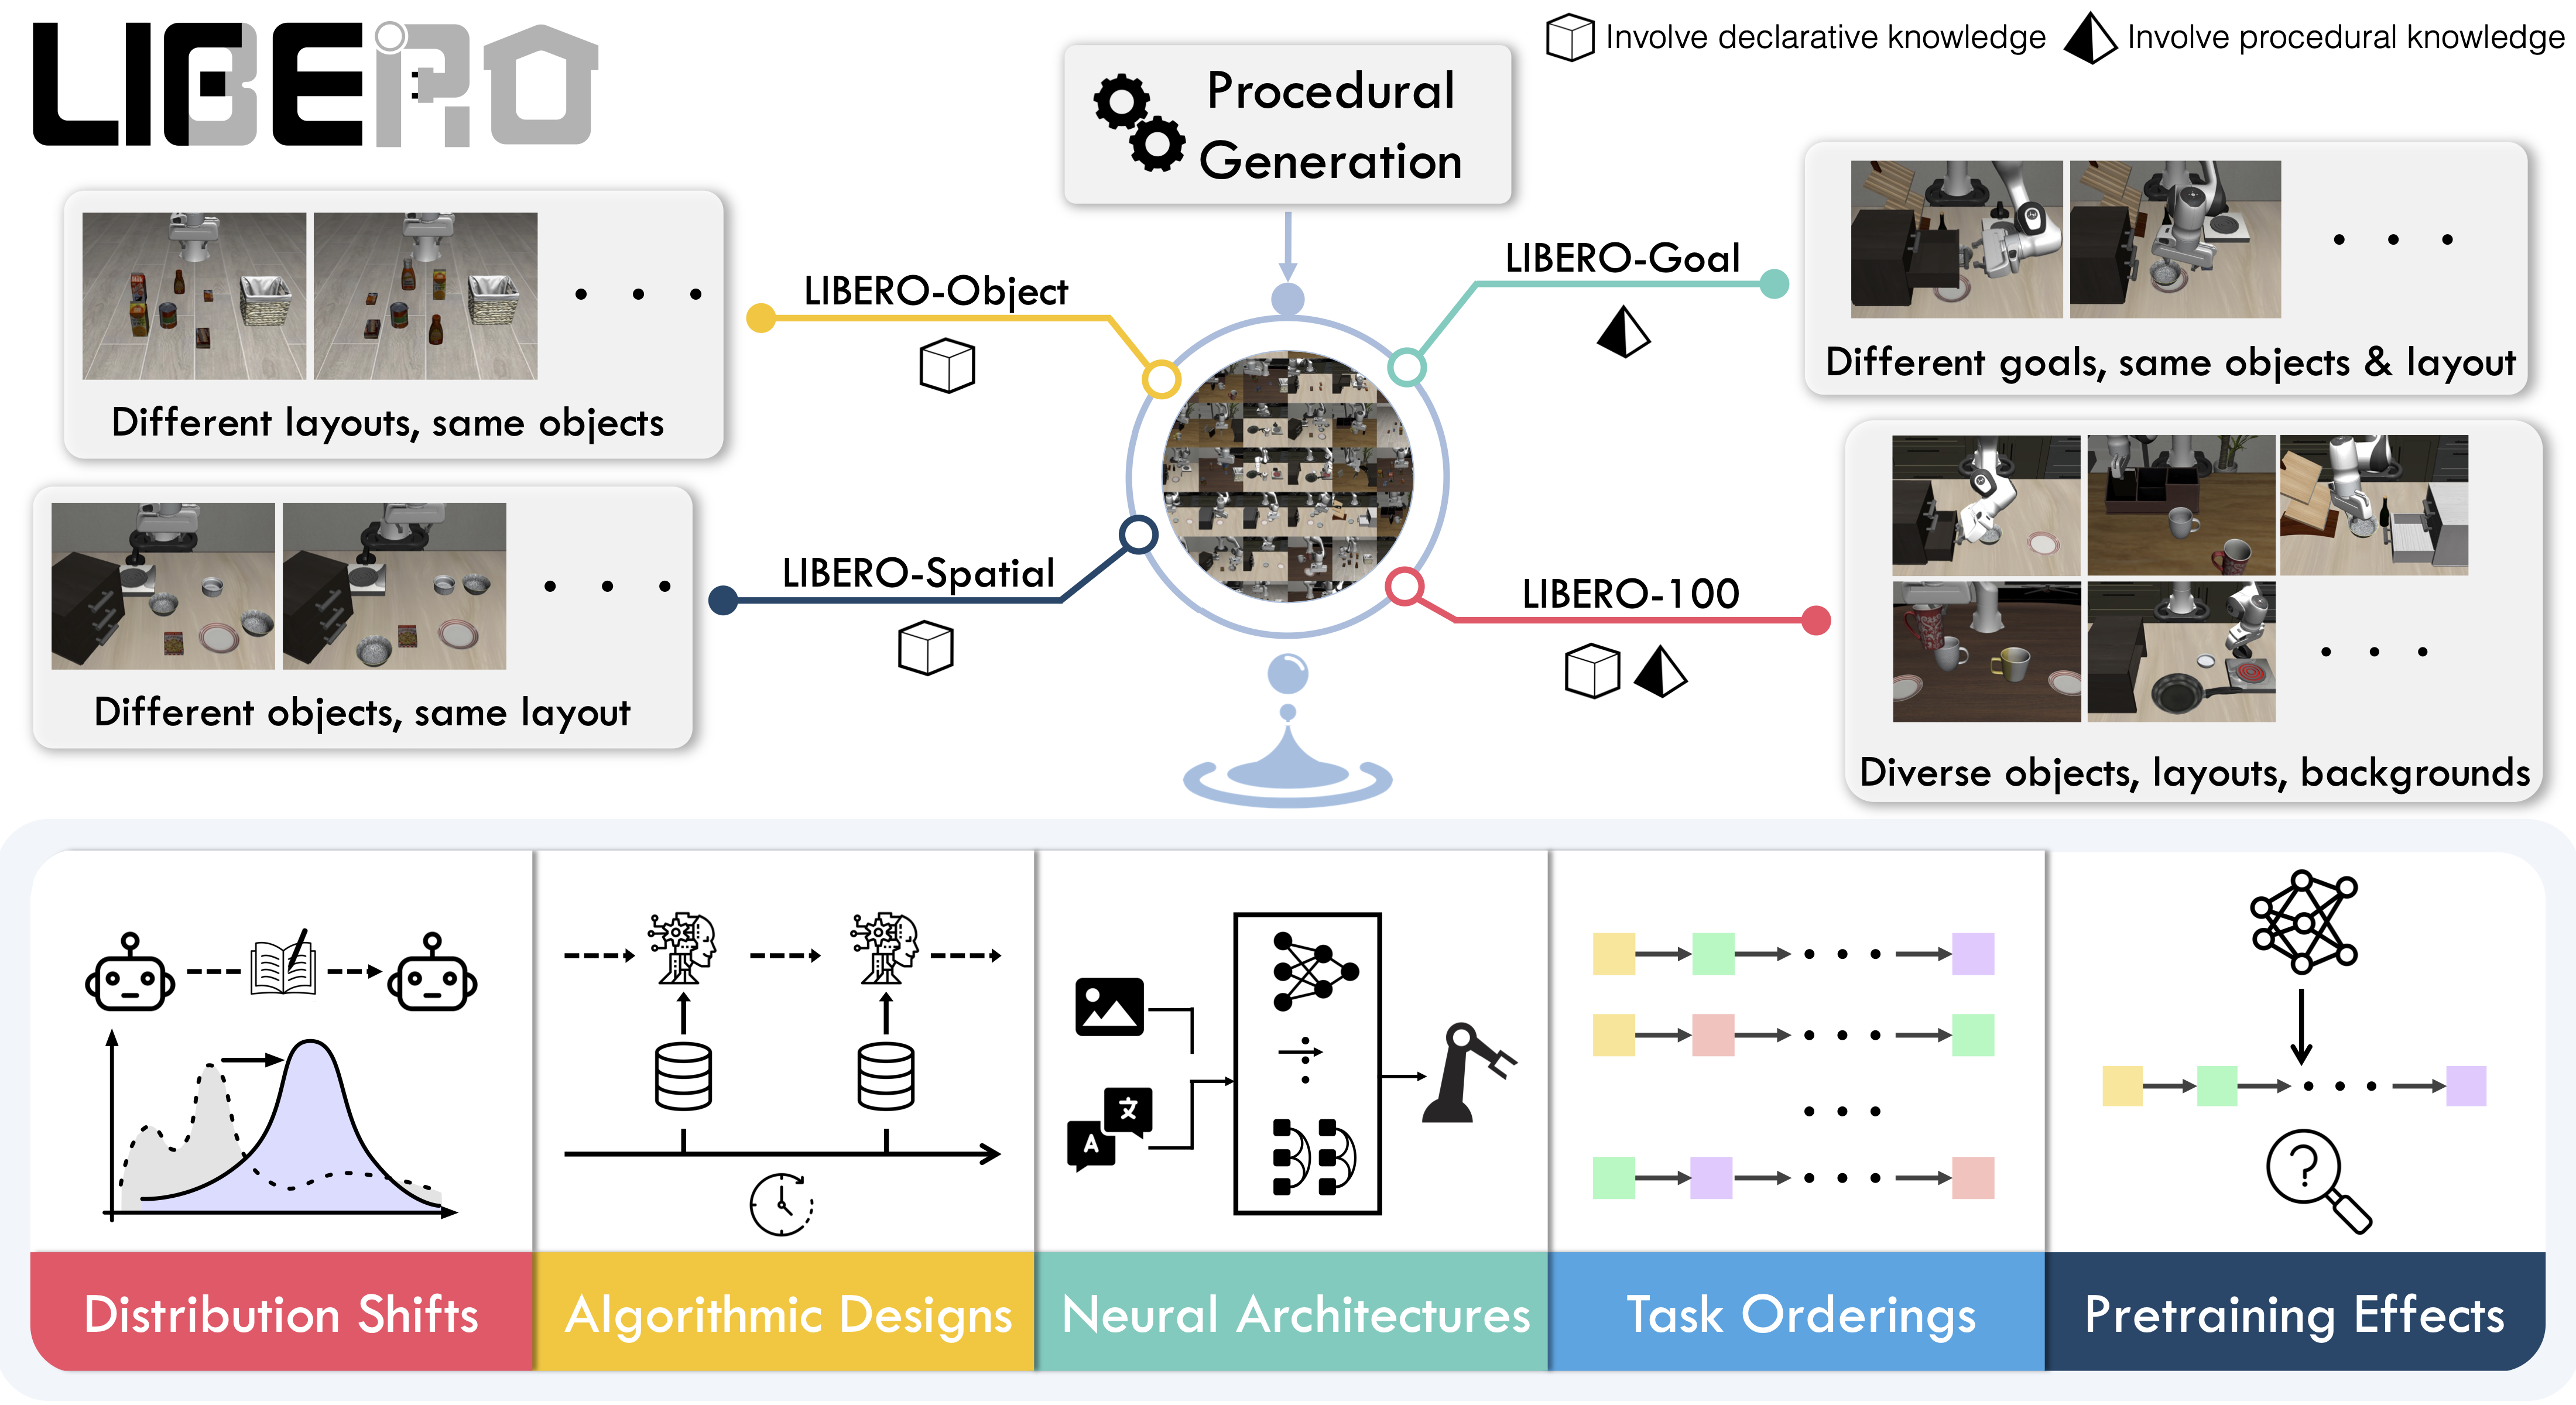
사용 가능한 작업
LIBERO에는 5개의 작업 스위트가 포함되어 있으며, 단순한 객체 조작부터 복잡한 다단계 시나리오까지 130개의 작업을 다룹니다:
| Suite | CLI 이름 | 작업 | 설명 |
|---|---|---|---|
| LIBERO-Spatial | libero_spatial | 10 | 공간적 관계에 대한 추론이 필요한 작업 |
| LIBERO-Object | libero_object | 10 | Tasks centered on manipulating different objects |
| LIBERO-Goal | libero_goal | 10 | 목표가 변경되는 목표 조건부 작업 |
| LIBERO-90 | libero_90 | 90 | LIBERO-100 컬렉션의 단기 지평선 작업 |
| LIBERO-Long | libero_10 | 10 | LIBERO-100 컬렉션의 장기 지평 작업 |
설치
LeRobot 설치 지침을 따른 후:
pip install -e ".[libero]"LIBERO requires Linux (`sys_platform == 'linux'`). LeRobot uses MuJoCo for simulation — set the rendering backend before training or evaluation:export MUJOCO_GL=egl # for headless servers (HPC, cloud)
평가
기본 로컬 평가
네 가지 표준 스위트(작업당 10에피소드)에 걸쳐 평가합니다:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --env.max_parallel_tasks=1
단일 스위트 평가
하나의 LIBERO suite에서 평가:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object \
  --eval.batch_size=2 \
--eval.n_episodes=3--env.task는 스위트(libero_object,libero_spatial등)를 선택합니다.--env.task_ids는 특정 작업 인덱스([0],[1,2,3]등)로 제한합니다. 생략하면 스위트의 모든 작업을 실행합니다.--eval.batch_size는 병렬로 실행되는 환경의 수를 제어합니다.--eval.n_episodes는 각 작업당 실행할 에피소드 수를 설정합니다.
멀티 스위트 평가
쉼표로 구분된 목록을 전달하여 여러 suite에 대해 정책을 한 번에 벤치마크할 수 있습니다:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object,libero_spatial \
  --eval.batch_size=1 \
  --eval.n_episodes=2
제어 모드
LIBERO는 두 가지 제어 모드, relative(기본값)와 absolute를 지원합니다. 서로 다른 VLA 체크포인트는 서로 다른 액션 파라미터화로 학습되므로, 해당 정책과 모드가 일치하는지 확인하세요:
--env.control_mode=relative # or "absolute"성능 재설정
기본적으로 LeRobot은 LIBERO의 하드 리셋 동작을 유지합니다. 고정된 초기 상태가 활성화된 경우, 에피소드마다 시뮬레이터 모델과 렌더러를 다시 구축하는 것을 건너뛰기 위해 소프트 리셋을 선택할 수 있습니다:
--env.init_states=true --env.hard_reset=falseSoft reset는 더 빠르지만, 환경의 settling 단계 이후에는 hard reset과 bit-identical하지 않으므로 카메라 관측값과 정책 결과가 약간 다를 수 있습니다. 벤치마크 결과를 재현할 때는 hard reset을 사용하세요.
정책 입력 및 출력
관찰 사항:
observation.state— 8차원 고유감각 특징(eef 위치, 축-각도 방향, 그리퍼 qpos)observation.images.image— 메인 카메라 뷰 (agentview_image), HWC uint8observation.images.image2— 손목 카메라 뷰 (robot0_eye_in_hand_image), HWC uint8
LeRobot enforces the `.images.*` prefix for visual features. Ensure your policy config `input_features` use the same naming keys, and that your dataset metadata keys follow this convention. If your data contains different keys, you must rename the observations to match what the policy expects, since naming keys are encoded inside the normalization statistics layer.
작업:
Box(-1, 1, shape=(7,))에서의 연속 제어 — 6D 엔드 이펙터 델타 + 1D 그리퍼
권장 평가 에피소드
재현 가능한 벤치마킹을 위해, 네 가지 표준 스위트(Spatial, Object, Goal, Long) 모두에서 작업당 10개의 에피소드를 사용하세요. 이를 통해 총 400개의 에피소드가 생성되며, 이는 공개된 결과에 사용된 프로토콜과 일치합니다. 성공률은 평가 시드에 따라 몇 퍼센트 정도 달라질 수 있으므로, 3개의 시드에 대해 평균을 내는 것을 권장합니다.
lerobot-eval은 모든 성공률 옆에 95% Wilson 구간(pc_success_ci95)을 보고합니다. 10에피소드에서 9/10을 기록한 작업의 구간은 대략 60%에서 98% 사이이며, 400에피소드 스위트 전체에서 80%를 기록한 경우의 구간은 대략 76%에서 84% 사이입니다. 특정 작업에서 구간이 겹치는 두 정책은 해당 실행에서 그 작업에서 차이가 있음을 입증받지 못한 것입니다. 이 구간은 어떤 에피소드가 추출되었는지를 포괄하며, 정책의 학습 시드는 포괄하지 않습니다. 학습 시드를 측정하려면 하나의 학습 실행 이상が必要です.
To compare two policies on the same episodes, use the same `--seed`, keep `--env.init_states=true`, and run each task in a single batch (`--eval.batch_size` equal to episodes per task).
학습
데이터셋
전처리된 두 개의 LIBERO 데이터셋은 LeRobot과 완전히 호환됩니다. 동일한 시연 데이터와 동일한 스키마를 포함하며, 카메라 프레임의 저장 방식에서만 차이가 있습니다:
| lerobot/libero | HuggingFaceVLA/libero | |
|---|---|---|
| 에피소드 / 프레임 / 태스크 | 1,693 / 273,465 / 40 | 1,693 / 273,465 / 40 |
| 카메라 | 2× 256×256×3 | 2× 256×256×3 |
| 상태 / 행동 차원 | 8 / 7 | 8 / 7 |
| 데이터셋 형식 | v3.0 | v3.0 |
| 카메라 인코딩 | MP4 비디오 | parquet의 PNG |
| 다운로드 크기 | 1.9 GB | 69.9 GB |
| 추가 의존성 | 비디오 백엔드(torchcodec 또는 pyav) | 없음 |
lerobot/libero를 권장합니다: 다운로드 크기가 37배 더 작고 로딩 속도는 동일합니다(워커당 약 330 samples/s). 비디오 재인코딩은 약간의 손실이 발생할 수 있으며, 비디오 디코딩 백엔드를 설치할 수 없는 경우 이미지 기반 변형을 사용하세요.
참고로, Physical Intelligence에서 공개한 원본 데이터셋은 다음과 같습니다:
Pin `--dataset.revision=` when reporting results — Hub datasets can be re-uploaded, and success rates are only comparable against the same data revision.
예시 학습 명령
SmolVLA를 권장 데이터셋으로 학습합니다:
lerobot-train \
  --policy.type=smolvla \
  --policy.load_vlm_weights=true \
  --policy.push_to_hub=false \
  --dataset.repo_id=lerobot/libero \
  --dataset.video_backend=torchcodec \
  --output_dir=./outputs/libero_smolvla \
  --steps=100000 \
  --batch_size=64
Hub에 결과를 공유하려면 --policy.push_to_hub=false를 --policy.repo_id=${HF_USER}/libero-smolvla로 교체하세요. 저장된 체크포인트는 평가 섹션에 나와 있듯이 lerobot-eval로 평가합니다.
발표된 결과 재현
Pi0.5의 LIBERO 벤치마크 결과를 재현합니다. Physical Intelligence의 LIBERO 베이스 모델(pi05_libero)을 가져와 HuggingFace LIBERO dataset을 사용하여 8개의 H100 GPU에서 배치 크기 256, bfloat16으로 6k 스텝 추가 파인튜닝을 수행했습니다.
파인튜닝된 모델: lerobot/pi05_libero_finetuned
평가 명령
lerobot-eval \
  --output_dir=./eval_logs/ \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --policy.path=lerobot/pi05_libero_finetuned \
  --policy.n_action_steps=10 \
  --env.max_parallel_tasks=1
n_action_steps=10를 설정하여, 원래의 OpenPI 구현과 일치하도록 했습니다.
결과
| 모델 | LIBERO Spatial | LIBERO Object | LIBERO 목표 | LIBERO 10 | 평균 |
|---|---|---|---|---|---|
| Pi0.5 (LeRobot) | 97.0 | 99.0 | 98.0 | 96.0 | 97.5 |
이 결과는 Physical Intelligence가 보고한 원래 결과와 일치합니다:
| 모델 | LIBERO Spatial | LIBERO Object | LIBERO 목표 | LIBERO 10 | 평균 |
|---|---|---|---|---|---|
| Pi0.5 (OpenPI) | 98.8 | 98.2 | 98.0 | 92.4 | 96.85 |