
LeRobot documentation
LIBERO
LIBERO
The commands below run the simulator locally. To keep its dependencies away from your policy's, serve it instead with `lerobot-env-server --config_path=docker/sim/configs/libero.yaml --sim.task=--docker=true`, where ` ` is the command's `--env.task`, and add `--env.server.endpoint=tcp/127.0.0.1:7448` to the command. A server runs the task it was started with (see [Simulation: local or served](./simulation)).
LIBERO, ömür boyu robot öğrenmesini incelemek için tasarlanmış bir ölçüm setidir; bu kavram, robotların yalnızca bir kez önceden eğitilmekle kalmayıp zaman içinde kullanıcılarıyla birlikte öğrenmeye ve uyum sağlamaya devam etmesi gerektiği fikrini ifade eder. LIBERO, bilgi aktarımına odaklanan standartlaştırılmış bir manipülasyon görevi seti sunar: bir robotun daha önce öğrendiklerini yeni durumlara ne ölçüde uygulayabildiği. LIBERO üzerinde değerlendirme yaparak farklı algoritmalar adil bir şekilde karşılaştırılabilir ve araştırmacılar birbirlerinin çalışmalarının üzerine inşa edebilir.
- Makale: Benchmarking Knowledge Transfer for Lifelong Robot Learning
- GitHub: Lifelong-Robot-Learning/LIBERO
- Proje web sitesi: libero-project.github.io
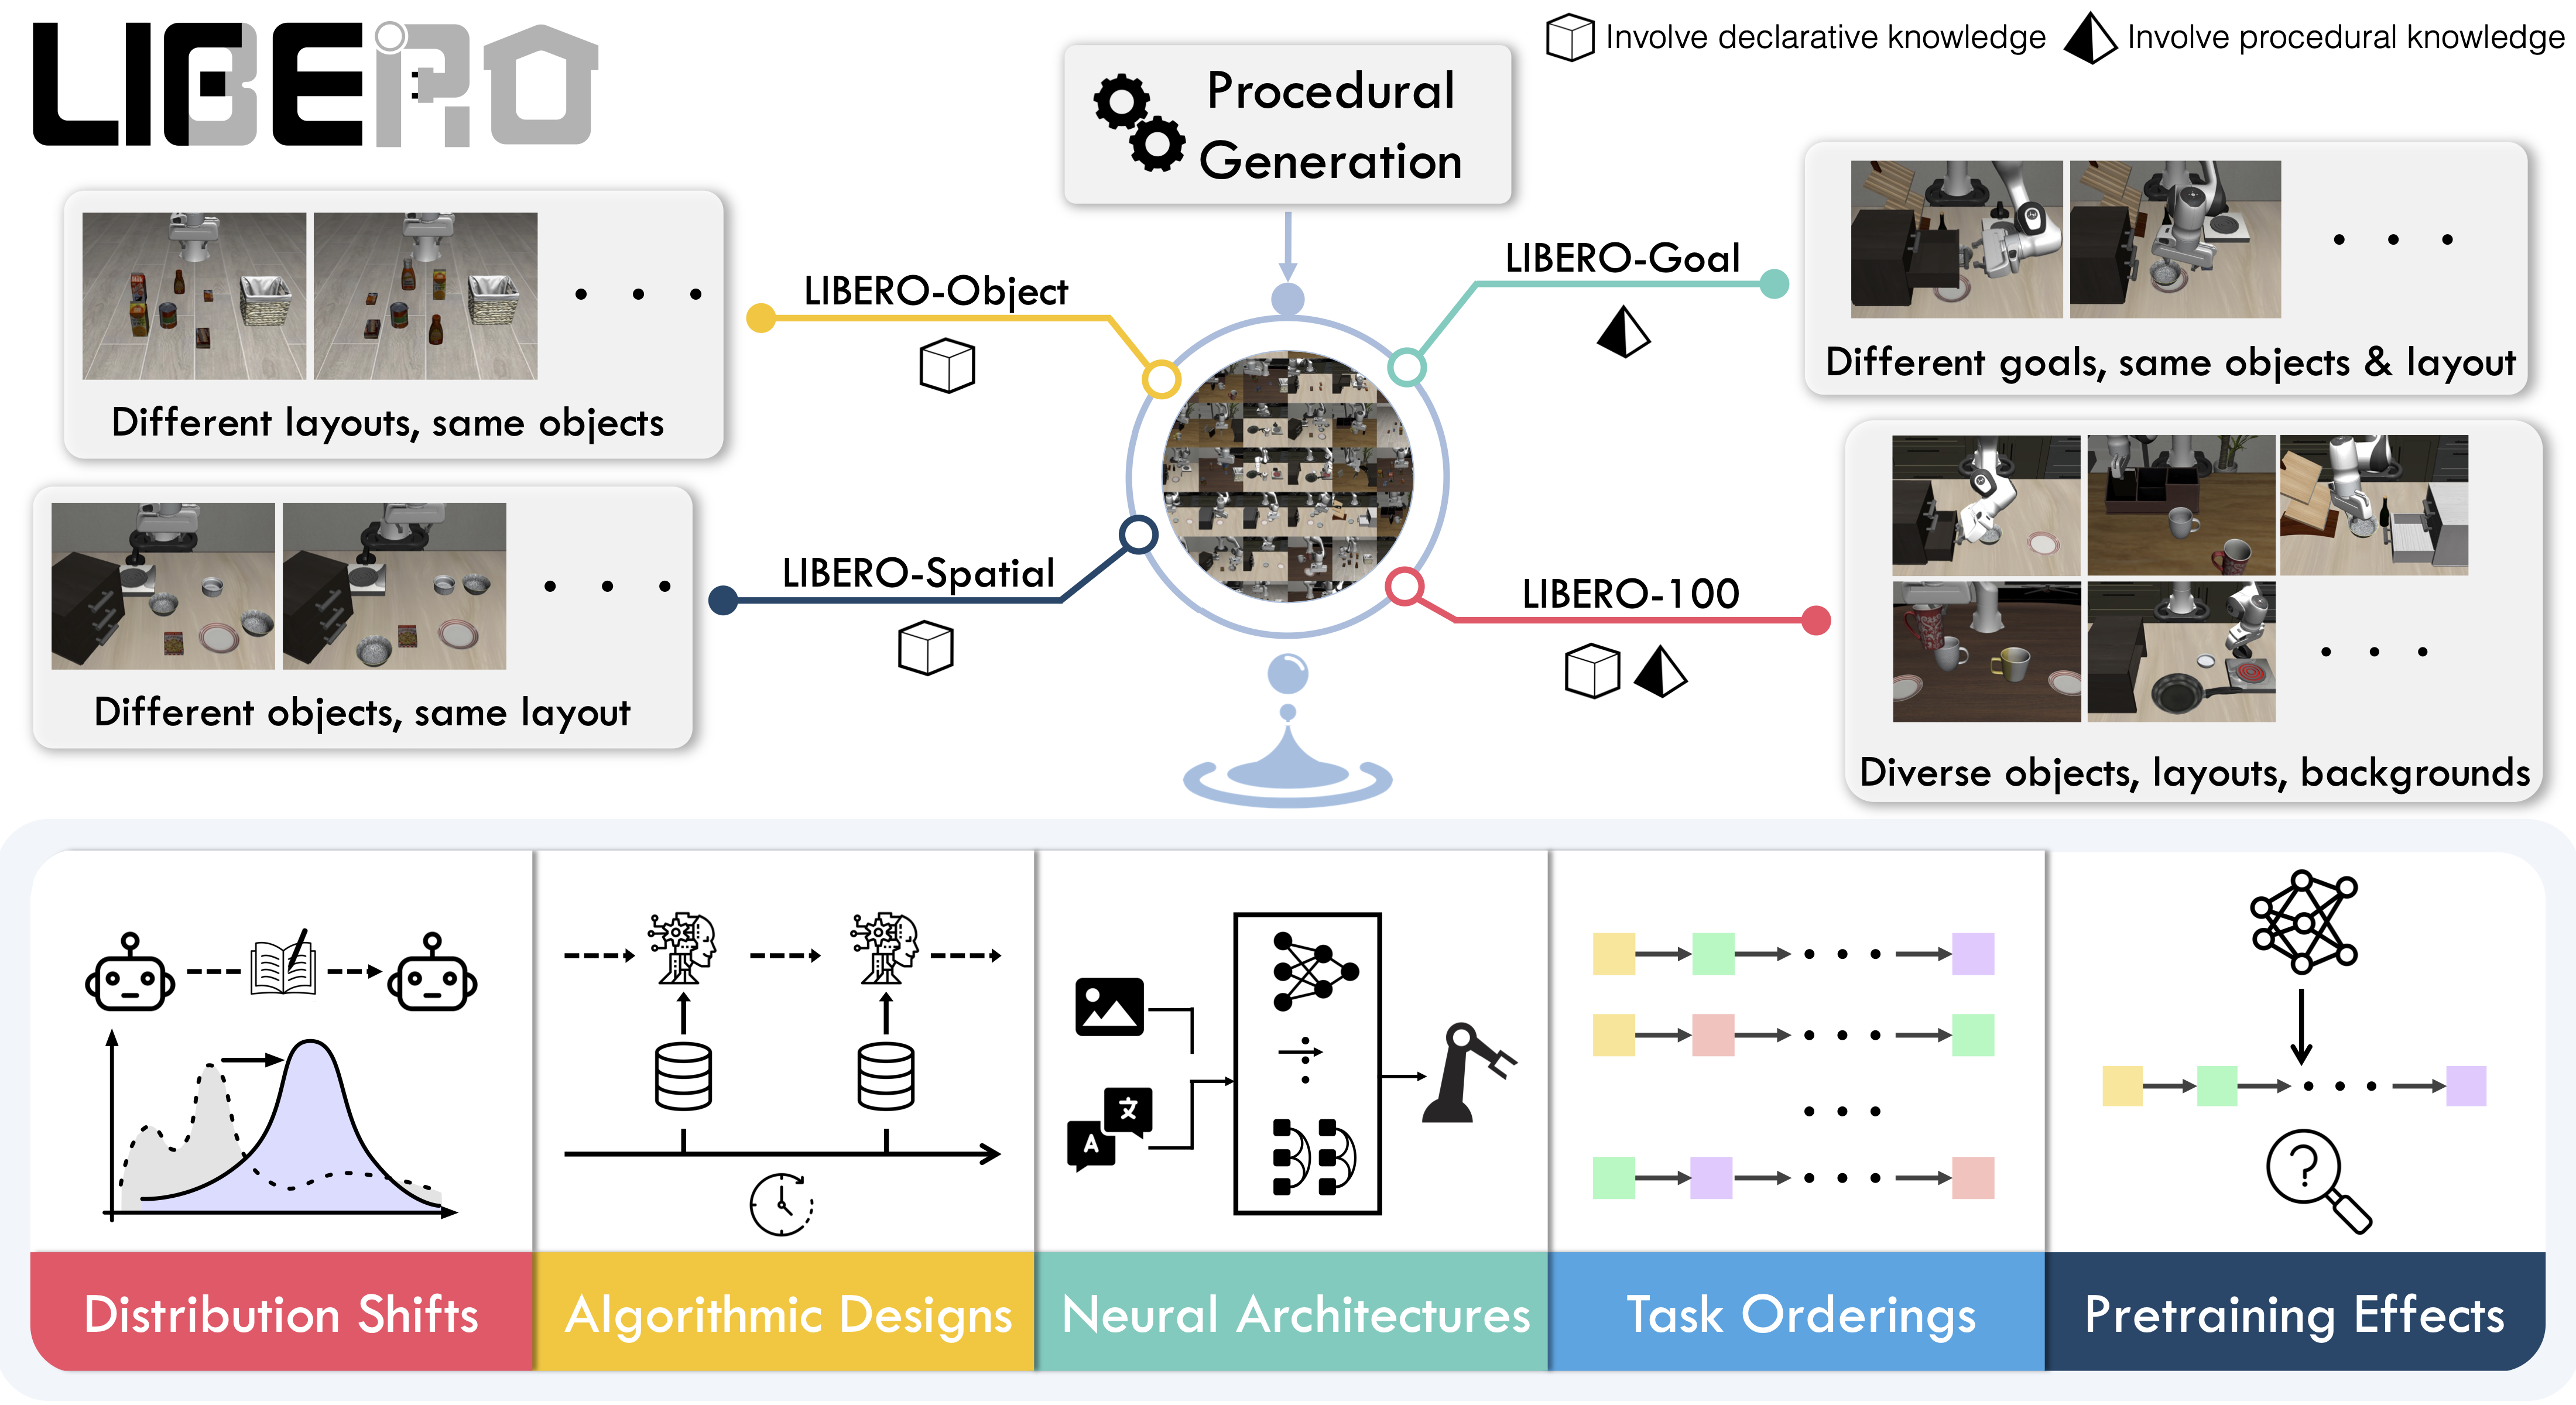
Mevcut görevler
LIBERO, basit nesne manipülasyonlarından karmaşık çok adımlı senaryolara kadar uzanan 130 görevi kapsayan beş görev seti içerir:
| Suite | CLI adı | Görevler | Açıklama |
|---|---|---|---|
| LIBERO-Spatial | libero_spatial | 10 | Uzamsal ilişkiler hakkında akıl yürütme gerektiren görevler |
| LIBERO-Object | libero_object | 10 | Farklı nesneleri manipüle etmeye odaklanan görevler |
| LIBERO-Goal | libero_goal | 10 | Hedefleri değişen hedef koşullu görevler |
| LIBERO-90 | libero_90 | 90 | LIBERO-100 koleksiyonundan kısa ufuklu görevler |
| LIBERO-Long | libero_10 | 10 | LIBERO-100 koleksiyonundan uzun vadeli görevler |
Kurulum
LeRobot kurulum talimatlarını izledikten sonra:
pip install -e ".[libero]"LIBERO requires Linux (`sys_platform == 'linux'`). LeRobot uses MuJoCo for simulation — set the rendering backend before training or evaluation:export MUJOCO_GL=egl # for headless servers (HPC, cloud)
Değerlendirme
Varsayılan yerel değerlendirme
Dört standart test setinde değerlendirin (görev başına 10 bölüm):
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --env.max_parallel_tasks=1
Tekli paket değerlendirmesi
Bir LIBERO süitinde değerlendirme yapın:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object \
  --eval.batch_size=2 \
--eval.n_episodes=3--env.task, test setini seçer (libero_object,libero_spatialvb.).--env.task_ids, belirli görev indekslerine ([0],[1,2,3]vb.) kısıtlar. Tüm görevleri çalıştırmak için bu parametreyi atlayın.--eval.batch_size, paralel olarak çalışan ortam sayısını kontrol eder.--eval.n_episodes, her görev için kaç bölümün çalıştırılacağını belirler.
Çoklu süit değerlendirmesi
Virgülle ayrılmış bir liste geçirerek bir politikayı birden fazla test setinde aynı anda ölçün:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object,libero_spatial \
  --eval.batch_size=1 \
  --eval.n_episodes=2
Kontrol modu
LIBERO iki kontrol modunu destekler: relative (varsayılan) ve absolute. Farklı VLA checkpoint'leri farklı eylem parametrelendirmeleriyle eğitildiğinden, modun politikanızla eşleştiğinden emin olun:
--env.control_mode=relative # or "absolute"Performansı sıfırla
Varsayılan olarak LeRobot, LIBERO’nun sert sıfırlama davranışını korur. Sabit başlangıç durumları etkinleştirildiğinde, her bölümde simülatör modelini ve render’ı yeniden oluşturmayı atlamak için yumuşak sıfırlamaları seçebilirsiniz:
--env.init_states=true --env.hard_reset=falseSoft sıfırlamalar daha hızlıdır ancak ortamın oturma adımlarından sonra hard sıfırlamalarla bit-bite aynı değildir; bu nedenle kamera gözlemleri ve politika sonuçları hafifçe farklılık gösterebilir. Benchmark sonuçlarını yeniden üretirken hard sıfırlamaları kullanın.
Politika girdileri ve çıktıları
Gözlemler:
observation.state— 8 boyutlu proprioseptif özellikler (eef konumu, eksen-açı yönelimi, gripper qpos)observation.images.image— ana kamera görünümü (agentview_image), HWC uint8observation.images.image2— bilek kamera görünümü (robot0_eye_in_hand_image), HWC uint8
LeRobot enforces the `.images.*` prefix for visual features. Ensure your policy config `input_features` use the same naming keys, and that your dataset metadata keys follow this convention. If your data contains different keys, you must rename the observations to match what the policy expects, since naming keys are encoded inside the normalization statistics layer.
Eylemler:
Box(-1, 1, shape=(7,))içinde sürekli kontrol — 6B uç efektor delta + 1B kavrama
Önerilen değerlendirme bölümleri
Yeniden üretilebilir kıyaslamalar için, dört standart süit (Spatial, Object, Goal, Long) boyunca görev başına 10 bölüm kullanın. Bu, toplamda 400 bölüm verir ve yayımlanan sonuçlar için kullanılan protokol ile eşleşir. Başarı oranları değerlendirme tohumları arasında birkaç yüzde farklılık gösterebilir, bu nedenle 3 tohum üzerinde ortalama almanızı öneririz.
lerobot-eval, her başarı oranının yanında %95 Wilson aralığını (pc_success_ci95) raporlar. 10 epizotta bir görevin 9/10 puan alması durumunda aralık yaklaşık %60 ile %98 arasındadır; 400 epizotluk bir test setinin toplamında %80 başarı oranı için aralık yaklaşık %76 ile %84 arasındadır. Bir görevde aralıkları örtüşen iki politika, o çalışmada o görevde farklılaştıklarına dair kanıtlanmamış demektir. Aralık, hangi epizotların seçildiğini kapsar; politikanın eğitim tohumunu kapsamaz ve bunu ölçmek için birden fazla eğitim çalışması gerekir.
To compare two policies on the same episodes, use the same `--seed`, keep `--env.init_states=true`, and run each task in a single batch (`--eval.batch_size` equal to episodes per task).
Eğitim
Veri seti
İki ön işlenmiş LIBERO veri seti LeRobot ile tam olarak uyumludur. Aynı şemaya sahip aynı gösterimleri içerirler ve kamera karelerinin nasıl saklandığı konusunda farklılık gösterirler:
| lerobot/libero | HuggingFaceVLA/libero | |
|---|---|---|
| epizotlar / kareler / görevler | 1,693 / 273,465 / 40 | 1,693 / 273,465 / 40 |
| kameralar | 2× 256×256×3 | 2× 256×256×3 |
| durum / eylem boyutları | 8 / 7 | 8 / 7 |
| veri seti biçimi | v3.0 | v3.0 |
| kamera kodlama | MP4 video | parquet içinde PNG |
| indirme boyutu | 1,9 GB | 69,9 GB |
| ek bağımlılık | video arka ucu (torchcodec veya pyav) | none |
lerobot/libero öneririz: 37 kat daha küçük indirme ve eşdeğer yükleme hızı (işçi başına ~330 örnek/sn). Video yeniden kodlaması hafif kayıplıdır; video çözme arka ucunu kuramıyorsanız görüntü tabanlı varyantı kullanın.
Referans olarak, Physical Intelligence tarafından yayımlanan orijinal veri seti:
Pin `--dataset.revision=` when reporting results — Hub datasets can be re-uploaded, and success rates are only comparable against the same data revision.
Örnek eğitim komutu
Önerilen veri setinde SmolVLA'yı eğitin:
lerobot-train \
  --policy.type=smolvla \
  --policy.load_vlm_weights=true \
  --policy.push_to_hub=false \
  --dataset.repo_id=lerobot/libero \
  --dataset.video_backend=torchcodec \
  --output_dir=./outputs/libero_smolvla \
  --steps=100000 \
  --batch_size=64
Sonucu Hub'da paylaşmak için --policy.push_to_hub=false ifadesini --policy.repo_id=${HF_USER}/libero-smolvla ile değiştirin. Kaydedilen checkpoint'leri, Değerlendirme bölümünde gösterildiği gibi lerobot-eval ile değerlendirin.
Yayınlanan sonuçların yeniden üretilmesi
Pi0.5 sonuçlarını LIBERO benchmark'unda yeniden üretiyoruz. Physical Intelligence LIBERO temel modelini (pi05_libero) alıyoruz ve HuggingFace LIBERO veri setini kullanarak 8 H100 GPU üzerinde, 256 batch boyutuyla bfloat16'da ek olarak 6k adım boyunca ince ayar yapıyoruz.
İnce ayarlanmış model: lerobot/pi05_libero_finetuned
Değerlendirme komutu
lerobot-eval \
  --output_dir=./eval_logs/ \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --policy.path=lerobot/pi05_libero_finetuned \
  --policy.n_action_steps=10 \
  --env.max_parallel_tasks=1
Orijinal OpenPI uygulamasıyla uyumlu olacak şekilde n_action_steps=10 olarak ayarladık.
Sonuçlar
| Model | LIBERO Uzamsal | LIBERO Nesne | LIBERO Hedef | LIBERO 10 | Ortalama |
|---|---|---|---|---|---|
| Pi0.5 (LeRobot) | 97.0 | 99.0 | 98.0 | 96.0 | 97.5 |
Bu sonuçlar, Physical Intelligence tarafından bildirilen orijinal sonuçlar ile tutarlıdır:
| Model | LIBERO Uzamsal | LIBERO Nesne | LIBERO Hedef | LIBERO 10 | Ortalama |
|---|---|---|---|---|---|
| Pi0.5 (OpenPI) | 98.8 | 98.2 | 98.0 | 92.4 | 96.85 |