
Transformers documentation
FastSpeech2Conformer
Model ini dipublikasikan di HF papers pada 2020-10-26 dan disumbangkan ke Hugging Face Transformers pada 2024-01-03.
FastSpeech2Conformer
Ikhtisar
Model FastSpeech2Conformer diusulkan melalui makalah Recent Developments On Espnet Toolkit Boosted By Conformer oleh Pengcheng Guo, Florian Boyer, Xuankai Chang, Tomoki Hayashi, Yosuke Higuchi, Hirofumi Inaguma, Naoyuki Kamo, Chenda Li, Daniel Garcia-Romero, Jiatong Shi, Jing Shi, Shinji Watanabe, Kun Wei, Wangyou Zhang, dan Yuekai Zhang.
Abstrak dari paper FastSpeech2 asli adalah sebagai berikut:
Model text-to-speech (TTS) non-otoregresif seperti FastSpeech (Ren et al., 2019) dapat mensintesis ucapan secara signifikan lebih cepat daripada model otoregresif sebelumnya dengan kualitas yang sebanding. Pelatihan model FastSpeech bergantung pada model guru otoregresif untuk prediksi durasi (untuk menyediakan lebih banyak informasi sebagai input) dan distilasi pengetahuan (untuk menyederhanakan distribusi data pada output), yang dapat memitigasi masalah pemetaan satu-ke-banyak (yaitu, variasi ucapan yang berbeda-beda berkorespondensi dengan teks yang sama) dalam TTS. Namun, FastSpeech memiliki beberapa kelemahan: 1) pipeline distilasi guru-murid yang rumit dan memakan waktu, 2) durasi yang diekstrak dari model guru tidak cukup akurat, dan mel-spektrogram target yang didistilasi dari model guru mengalami kehilangan informasi akibat penyederhanaan data, keduanya membatasi kualitas suara. Dalam makalah ini, kami mengusulkan FastSpeech 2, yang mengatasi masalah pada FastSpeech dan lebih baik menyelesaikan masalah pemetaan satu-ke-banyak dalam TTS dengan 1) melatih model secara langsung dengan target ground-truth alih-alih output yang disederhanakan dari guru, dan 2) memperkenalkan lebih banyak informasi variasi ucapan (misalnya, pitch, energi, dan durasi yang lebih akurat) sebagai input kondisional. Secara spesifik, kami mengekstrak durasi, pitch, dan energi dari waveform ucapan dan langsung menggunakannya sebagai input kondisional dalam pelatihan serta menggunakan nilai prediksi dalam inferensi. Kami juga merancang FastSpeech 2s, yang merupakan upaya pertama untuk menghasilkan waveform ucapan secara langsung dari teks secara paralel, menikmati keuntungan dari inferensi end-to-end penuh. Hasil eksperimen menunjukkan bahwa 1) FastSpeech 2 mencapai percepatan pelatihan 3x dibandingkan FastSpeech, dan FastSpeech 2s menikmati kecepatan inferensi yang bahkan lebih cepat; 2) FastSpeech 2 dan 2s melampaui FastSpeech dalam kualitas suara, dan FastSpeech 2 bahkan dapat melampaui model otoregresif. Contoh audio tersedia di https://speechresearch.github.io/fastspeech2/.
Model ini disumbangkan oleh Connor Henderson. Kode aslinya dapat ditemukan di sini.
🤗 Arsitektur Model
Struktur umum FastSpeech2 dengan dekodeur Mel-spectrogram diimplementasikan, dan blok transformer tradisional diganti dengan blok conformer seperti yang dilakukan di pustaka ESPnet.
Arsitektur Model FastSpeech2

Blok Conformer

Modul Konvolusi
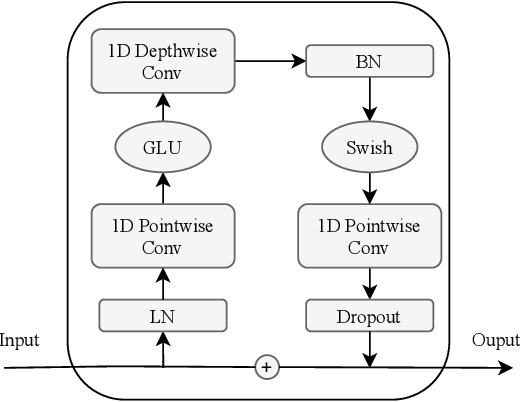
🤗 Penggunaan Transformers
Anda dapat menjalankan FastSpeech2Conformer secara lokal dengan pustaka 🤗 Transformers.
- Pertama, instal library Transformers 🤗, g2p-en:
pip install --upgrade pip
pip install --upgrade transformers g2p-en
- Jalankan inferensi melalui kode pemodelan Transformers dengan model dan hifigan secara terpisah
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerModel, FastSpeech2ConformerTokenizer


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer", device_map="auto")
output_dict = model(input_ids, return_dict=True)
spectrogram = output_dict["spectrogram"]

hifigan = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
waveform = hifigan(spectrogram)

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Jalankan inferensi melalui kode pemodelan Transformers dengan model dan hifigan yang digabungkan
import soundfile as sf

from transformers import FastSpeech2ConformerTokenizer, FastSpeech2ConformerWithHifiGan


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
output_dict = model(input_ids, return_dict=True)
waveform = output_dict["waveform"]

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Jalankan inferensi dengan pipeline dan tentukan vocoder yang akan digunakan
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, pipeline


vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
synthesiser = pipeline(model="espnet/fastspeech2_conformer", vocoder=vocoder)

speech = synthesiser("Hello, my dog is cooler than you!")

sf.write("speech.wav", speech["audio"].squeeze(), samplerate=speech["sampling_rate"])
FastSpeech2ConformerConfig
kelas transformers.FastSpeech2ConformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truehidden_size: int = 384vocab_size: int = 78num_mel_bins: int = 80encoder_num_attention_heads: int = 2encoder_layers: int = 4encoder_linear_units: int = 1536decoder_layers: int = 4decoder_num_attention_heads: int = 2decoder_linear_units: int = 1536speech_decoder_postnet_layers: int = 5speech_decoder_postnet_units: int = 256speech_decoder_postnet_kernel: int = 5positionwise_conv_kernel_size: int = 3encoder_normalize_before: bool = Falsedecoder_normalize_before: bool = Falseencoder_concat_after: bool = Falsedecoder_concat_after: bool = Falsereduction_factor: int = 1speaking_speed: float = 1.0use_macaron_style_in_conformer: bool = Trueuse_cnn_in_conformer: bool = Trueencoder_kernel_size: int = 7decoder_kernel_size: int = 31duration_predictor_layers: int = 2duration_predictor_channels: int = 256duration_predictor_kernel_size: int = 3energy_predictor_layers: int = 2energy_predictor_channels: int = 256energy_predictor_kernel_size: int = 3energy_predictor_dropout: float | int = 0.5energy_embed_kernel_size: int = 1energy_embed_dropout: float | int = 0.0stop_gradient_from_energy_predictor: bool = Falsepitch_predictor_layers: int = 5pitch_predictor_channels: int = 256pitch_predictor_kernel_size: int = 5pitch_predictor_dropout: float | int = 0.5pitch_embed_kernel_size: int = 1pitch_embed_dropout: float | int = 0.0stop_gradient_from_pitch_predictor: bool = Trueencoder_dropout_rate: float | int = 0.2encoder_positional_dropout_rate: float | int = 0.2encoder_attention_dropout_rate: float | int = 0.2decoder_dropout_rate: float | int = 0.2decoder_positional_dropout_rate: float | int = 0.2decoder_attention_dropout_rate: float | int = 0.2duration_predictor_dropout_rate: float | int = 0.2speech_decoder_postnet_dropout: float | int = 0.5max_source_positions: int = 5000use_masking: bool = Trueuse_weighted_masking: bool = Falsenum_speakers: int | None = Nonenum_languages: int | None = Nonespeaker_embed_dim: int | None = Noneconvolution_bias: bool = True )
Parameter
- is_encoder_decoder (
bool, opsional, defaultnyaTrue) — Apakah model digunakan sebagai encoder/decoder atau tidak. - hidden_size (
int, opsional, default384) — Dimensi dari representasi tersembunyi. - vocab_size (
int, opsional, default78) — Ukuran kosakata model. Menentukan jumlah token berbeda yang dapat direpresentasikan olehinput_ids. - num_mel_bins (
int, opsional, default80) — Jumlah fitur mel yang digunakan per frame input. Seharusnya sesuai dengan nilai yang digunakan di kelasAutoFeatureExtractor. - encoder_num_attention_heads (
int, opsional, default 2) — Jumlah kepala perhatian (attention heads) dalam encoder. - encoder_layers (
int, opsional, default4) — Jumlah lapisan tersembunyi dalam encoder Transformer. Akan menggunakan nilai yang sama dengannum_layersjika tidak diatur. - encoder_linear_units (
int, opsional, default 1536) — Jumlah unit pada lapisan linear dari encoder. - decoder_layers (
int, opsional, default4) — Jumlah lapisan tersembunyi dalam decoder Transformer. Akan menggunakan nilai yang sama dengannum_layersjika tidak diatur. - decoder_num_attention_heads (
int, opsional, default2) — Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer. - decoder_linear_units (
int, opsional, default 1536) — Jumlah unit pada lapisan linear dari decoder. - speech_decoder_postnet_layers (
int, opsional, defaultnya 5) — Jumlah lapisan pada post-net dari speech decoder. - speech_decoder_postnet_units (
int, opsional, default 256) — Jumlah unit pada lapisan post-net dari speech decoder. - speech_decoder_postnet_kernel (
int, opsional, default 5) — Ukuran kernel pada post-net dari speech decoder. - positionwise_conv_kernel_size (
int, opsional, defaultnya 3) — Ukuran kernel konvolusi yang digunakan pada lapisan position-wise. - encoder_normalize_before (
bool, opsional, defaultnyaFalse) — Menentukan apakah normalisasi dilakukan sebelum lapisan encoder. - decoder_normalize_before (
bool, opsional, defaultFalse) — Menentukan apakah normalisasi dilakukan sebelum lapisan decoder. - encoder_concat_after (
bool, opsional, defaultnyaFalse) — Menentukan apakah akan melakukan penggabungan (concatenation) setelah lapisan encoder. - decoder_concat_after (
bool, opsional, defaultnyaFalse) — Menentukan apakah akan melakukan penggabungan (concatenation) setelah lapisan decoder. - reduction_factor (
int, opsional, default 1) — Faktor pengurangan laju bingkai ucapan. - speaking_speed (
float, opsional, default 1.0) — Kecepatan ucapan yang dihasilkan. - use_macaron_style_in_conformer (
bool, opsional, defaultnyaTrue) — Menentukan apakah akan menggunakan gaya macaron dalam conformer. - use_cnn_in_conformer (
bool, opsional, defaultnyaTrue) — Menentukan apakah jaringan saraf konvolusional akan digunakan dalam conformer. - encoder_kernel_size (
int, opsional, defaultnya 7) — Ukuran kernel yang digunakan dalam encoder. - decoder_kernel_size (
int, opsional, defaultnya 31) — Ukuran kernel yang digunakan dalam decoder. - duration_predictor_layers (
int, opsional, defaultnya 2) — Jumlah lapisan dalam duration predictor. - duration_predictor_channels (
int, opsional, defaultnya 256) — Jumlah channel dalam duration predictor. - duration_predictor_kernel_size (
int, opsional, default 3) — Ukuran kernel yang digunakan dalam duration predictor. - energy_predictor_layers (
int, opsional, defaultnya 2) — Jumlah lapisan dalam prediktor energi. - energy_predictor_channels (
int, opsional, defaultnya 256) — Jumlah channel dalam energy predictor. - energy_predictor_kernel_size (
int, opsional, defaultnya 3) — Ukuran kernel yang digunakan dalam prediktor energi. - energy_predictor_dropout (
float, opsional, default 0.5) — Tingkat dropout pada prediktor energi. - energy_embed_kernel_size (
int, opsional, defaultnya 1) — Ukuran kernel yang digunakan pada lapisan energy embed. - energy_embed_dropout (
float, opsional, default 0.0) — Tingkat dropout pada lapisan energy embed. - stop_gradient_from_energy_predictor (
bool, opsional, defaultFalse) — Menentukan apakah gradien dari energy predictor akan dihentikan. - pitch_predictor_layers (
int, opsional, defaultnya 5) — Jumlah lapisan dalam prediktor pitch. - pitch_predictor_channels (
int, opsional, default 256) — Jumlah channel dalam pitch predictor. - pitch_predictor_kernel_size (
int, opsional, default 5) — Ukuran kernel yang digunakan dalam prediktor pitch. - pitch_predictor_dropout (
float, opsional, default 0.5) — Tingkat dropout pada prediktor pitch. - pitch_embed_kernel_size (
int, opsional, defaultnya 1) — Ukuran kernel yang digunakan di lapisan pitch embed. - pitch_embed_dropout (
float, opsional, default 0.0) — Tingkat dropout pada lapisan pitch embed. - stop_gradient_from_pitch_predictor (
bool, opsional, defaultnyaTrue) — Menentukan apakah gradien dari pitch predictor akan dihentikan. - encoder_dropout_rate (
float, opsional, default 0.2) — Tingkat dropout pada encoder. - encoder_positional_dropout_rate (
float, opsional, default 0.2) — Tingkat dropout posisional di encoder. - encoder_attention_dropout_rate (
float, opsional, default 0.2) — Tingkat dropout perhatian di encoder. - decoder_dropout_rate (
float, opsional, default 0.2) — Tingkat dropout pada decoder. - decoder_positional_dropout_rate (
float, opsional, default 0.2) — Tingkat dropout posisional di decoder. - decoder_attention_dropout_rate (
float, opsional, default 0.2) — Tingkat dropout perhatian di decoder. - duration_predictor_dropout_rate (
float, opsional, default 0.2) — Tingkat dropout pada duration predictor. - speech_decoder_postnet_dropout (
float, opsional, default 0.5) — Tingkat dropout pada postnet decoder ucapan. - max_source_positions (
int, opsional, default 5000) — jika"relative"position embeddings digunakan, mendefinisikan posisi input sumber maksimum. - use_masking (
bool, opsional, defaultnyaTrue) — Menentukan apakah masking akan digunakan dalam model. - use_weighted_masking (
bool, opsional, defaultFalse) — Menentukan apakah akan menggunakan weighted masking pada model. - num_speakers (
int, opsional) — Jumlah pembicara. Jika diset ke > 1, asumsikan bahwa id pembicara akan diberikan sebagai input dan gunakan lapisan embedding id pembicara. - num_languages (
int, opsional) — Jumlah bahasa. Jika diset ke > 1, diasumsikan bahwa id bahasa akan diberikan sebagai input dan gunakan lapisan embedding id bahasa. - speaker_embed_dim (
int, opsional) — Dimensi speaker embedding. Jika diset ke > 0, diasumsikan bahwa speaker_embedding akan disediakan sebagai input. - convolution_bias (
bool, opsional, defaultTrue) — Menentukan apakah bias akan digunakan pada konvolusi dalam modul konvolusi conformer.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari FastSpeech2ConformerModel. Kelas ini digunakan untuk membuat model Fastspeech2 Conformer sesuai dengan argumen yang ditentukan, yang mendefinisikan arsitektur model. Membuat konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari espnet/fastspeech2_conformer
Objek konfigurasi mewarisi dari PreTrainedConfig dan dapat digunakan untuk mengontrol output model. Baca dokumentasi dari PreTrainedConfig untuk informasi lebih lanjut.
Contoh:
>>> from transformers import FastSpeech2ConformerModel, FastSpeech2ConformerConfig

>>> # Initializing a FastSpeech2Conformer style configuration
>>> configuration = FastSpeech2ConformerConfig()

>>> # Initializing a model from the FastSpeech2Conformer style configuration
>>> model = FastSpeech2ConformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerHifiGanConfig
kelas transformers.FastSpeech2ConformerHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_in_dim: int = 80upsample_initial_channel: int = 512upsample_rates: list[int] | tuple[int, ...] = (8, 8, 2, 2)upsample_kernel_sizes: list[int] | tuple[int, ...] = (16, 16, 4, 4)resblock_kernel_sizes: list[int] | tuple[int, ...] = (3, 7, 11)resblock_dilation_sizes: list | tuple | None = Noneinitializer_range: float = 0.01leaky_relu_slope: float = 0.1normalize_before: bool = True )
Parameter
- model_in_dim (
int, opsional, defaultnya 80) — Jumlah bin frekuensi dalam spektrogram log-mel input. - upsample_initial_channel (
int, opsional, default 512) — Jumlah saluran input ke jaringan upsampling. - upsample_rates (
tuple[int]ataulist[int], opsional, defaultnya[8, 8, 2, 2]) — Tuple dari bilangan bulat yang mendefinisikan stride dari setiap lapisan konvolusi 1D dalam jaringan upsampling. Panjang dari upsample_rates mendefinisikan jumlah lapisan konvolusi dan harus sesuai dengan panjang dari upsample_kernel_sizes. - upsample_kernel_sizes (
tuple[int]ataulist[int], opsional, defaultnya[16, 16, 4, 4]) — Tuple dari bilangan bulat yang mendefinisikan ukuran kernel dari setiap lapisan konvolusional 1D dalam jaringan upsampling. Panjang dari upsample_kernel_sizes mendefinisikan jumlah lapisan konvolusional dan harus sesuai dengan panjang dari upsample_rates. - resblock_kernel_sizes (
tuple[int]ataulist[int], opsional, defaultnya[3, 7, 11]) — Tuple dari bilangan bulat yang mendefinisikan ukuran kernel dari lapisan konvolusi 1D dalam modul multi-receptive field fusion (MRF). - resblock_dilation_sizes (
tuple[tuple[int]]ataulist[list[int]], opsional, defaultnya[[1, 3, 5], [1, 3, 5], [1, 3, 5]]) — Tuple bersarang dari bilangan bulat yang mendefinisikan laju dilasi dari lapisan konvolusional 1D yang berdilasi dalam modul multi-receptive field fusion (MRF). - initializer_range (
float, opsional, defaultnya0.01) — Standar deviasi dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot. - leaky_relu_slope (
float, opsional, default 0.1) — Sudut kemiringan negatif yang digunakan oleh aktivasi leaky ReLU. - normalize_before (
bool, opsional, defaultTrue) — Apakah akan menormalisasi spektrogram sebelum vokoding menggunakan mean dan variance yang dipelajari oleh vokoder.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari FastSpeech2ConformerModel. Kelas ini digunakan untuk membuat model Fastspeech2 Conformer sesuai dengan argumen yang ditentukan, yang mendefinisikan arsitektur model. Membuat konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari espnet/fastspeech2_conformer_with_hifigan
Objek konfigurasi mewarisi dari PreTrainedConfig dan dapat digunakan untuk mengontrol output model. Baca dokumentasi dari PreTrainedConfig untuk informasi lebih lanjut.
Contoh:
>>> from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerHifiGanConfig

>>> # Initializing a FastSpeech2ConformerHifiGan configuration
>>> configuration = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = FastSpeech2ConformerHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerWithHifiGanConfig
kelas transformers.FastSpeech2ConformerWithHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevocoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None )
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari FastSpeech2ConformerModel. Kelas ini digunakan untuk membuat model Fastspeech2 Conformer sesuai dengan argumen yang ditentukan, yang mendefinisikan arsitektur model. Membuat konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari espnet/fastspeech2_conformer_with_hifigan
Objek konfigurasi mewarisi dari PreTrainedConfig dan dapat digunakan untuk mengontrol output model. Baca dokumentasi dari PreTrainedConfig untuk informasi lebih lanjut.
Contoh:
>>> from transformers import (
...     FastSpeech2ConformerConfig,
...     FastSpeech2ConformerHifiGanConfig,
...     FastSpeech2ConformerWithHifiGanConfig,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> # Initializing FastSpeech2ConformerWithHifiGan sub-modules configurations.
>>> model_config = FastSpeech2ConformerConfig()
>>> vocoder_config = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a FastSpeech2ConformerWithHifiGan module style configuration
>>> configuration = FastSpeech2ConformerWithHifiGanConfig(model_config.to_dict(), vocoder_config.to_dict())

>>> # Initializing a model (with random weights)
>>> model = FastSpeech2ConformerWithHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerTokenizer
kelas transformers.FastSpeech2ConformerTokenizer
< source >( vocab_filebos_token = '<sos/eos>'eos_token = '<sos/eos>'pad_token = '<blank>'unk_token = '<unk>'should_strip_spaces = False**kwargs )
Parameter
- vocab_file (
str) — Path ke file kosakata. - bos_token (
str, opsional, defaultnya"<sos/eos>") — Token awal urutan. Perhatikan bahwa untuk FastSpeech2, token ini sama denganeos_token. - eos_token (
str, opsional, defaultnya"<sos/eos>") — Token akhir urutan. Perhatikan bahwa untuk FastSpeech2, token ini sama denganbos_token. - pad_token (
str, opsional, defaultnya"<blank>") — Token yang digunakan untuk padding, misalnya saat membatching urutan dengan panjang yang berbeda. - unk_token (
str, opsional, default"<unk>") — Token yang tidak diketahui. Token yang tidak ada dalam kosakata tidak dapat dikonversi menjadi ID dan akan diset sebagai token ini sebagai gantinya. - should_strip_spaces (
bool, opsional, defaultnyaFalse) — Apakah akan menghapus spasi dari daftar token.
Konstruksi tokenizer FastSpeech2Conformer.
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
Parameter
- text (
str,list[str],list[list[str]], opsional) — Sequens atau batch dari sequens yang akan dienkod. Setiap sequens dapat berupa string atau daftar string (string yang sudah dipretokenisasi). Jika sequens diberikan sebagai daftar string (pretokenized), Anda harus mengaturis_split_into_words=True(untuk menghilangkan ambiguitas dengan batch dari sequens). - text_pair (
str,list[str],list[list[str]], opsional) — Urutan atau batch dari urutan yang akan dienkod. Setiap urutan dapat berupa string atau daftar string (string yang sudah dipretokenisasi). Jika urutan diberikan sebagai daftar string (pretokenized), Anda harus mengaturis_split_into_words=True(untuk menghilangkan ambiguitas dengan batch dari urutan). - text_target (
str,list[str],list[list[str]], opsional) — Sequens atau batch sequens yang akan dikodekan sebagai teks target. Setiap sequens dapat berupa string atau daftar string (string pretokenized). Jika sequens diberikan sebagai daftar string (pretokenized), Anda harus mengaturis_split_into_words=True(untuk menghilangkan ambiguitas dengan batch sequens). - text_pair_target (
str,list[str],list[list[str]], opsional) — Urutan atau batch urutan yang akan dikodekan sebagai teks target. Setiap urutan dapat berupa string atau daftar string (string pretokenized). Jika urutan diberikan sebagai daftar string (pretokenized), Anda harus mengaturis_split_into_words=True(untuk menghilangkan ambiguitas dengan batch urutan). - tokenizer_kwargs (
dict[str, Any], opsional) — Kwargs tambahan untuk diteruskan ke tokenizer. Kwargs ini akan digabungkan dengan parameter eksplisit dan kwargs lainnya, dengan parameter eksplisit memiliki prioritas lebih tinggi. - add_special_tokens (
bool, opsional, defaultTrue) — Apakah akan menambahkan token khusus saat meng-encode urutan. Ini akan menggunakan fungsiPretrainedTokenizerBase.build_inputs_with_special_tokensyang mendasarinya, yang mendefinisikan token mana yang ditambahkan secara otomatis ke input ids. Ini berguna jika Anda ingin menambahkan tokenbosataueossecara otomatis. - padding (
bool,stratau PaddingStrategy, opsional, defaultnyaFalse) — Mengaktifkan dan mengontrol padding. Menerima nilai-nilai berikut:Trueatau'longest': Pad hingga urutan terpanjang dalam batch (atau tanpa padding jika hanya satu urutan yang diberikan).'max_length': Pad hingga panjang maksimum yang ditentukan dengan argumenmax_lengthatau hingga panjang input maksimum yang dapat diterima oleh model jika argumen tersebut tidak diberikan.Falseatau'do_not_pad'(default): Tidak ada padding (yaitu, dapat menghasilkan batch dengan urutan yang panjangnya berbeda).
- truncation (
bool,stratau TruncationStrategy, opsional, defaultnyaFalse) — Mengaktifkan dan mengontrol pemotongan. Menerima nilai-nilai berikut:Trueatau'longest_first': Memotong hingga panjang maksimum yang ditentukan dengan argumenmax_lengthatau hingga panjang input maksimum yang dapat diterima oleh model jika argumen tersebut tidak diberikan. Ini akan memotong per token, dengan menghapus satu token dari urutan terpanjang dalam pasangan jika sepasang urutan (atau batch pasangan) diberikan.'only_first': Potong hingga panjang maksimum yang ditentukan dengan argumenmax_lengthatau hingga panjang input maksimum yang dapat diterima oleh model jika argumen tersebut tidak diberikan. Ini hanya akan memotong urutan pertama dari sebuah pasangan jika sepasang urutan (atau batch dari pasangan) diberikan.'only_second': Potong hingga panjang maksimum yang ditentukan dengan argumenmax_lengthatau hingga panjang input maksimum yang dapat diterima oleh model jika argumen tersebut tidak diberikan. Ini hanya akan memotong urutan kedua dari sebuah pasangan jika sepasang urutan (atau batch dari pasangan) diberikan.Falseatau'do_not_truncate'(default): Tidak ada pemotongan (yaitu, dapat menghasilkan batch dengan panjang sekuens yang lebih besar dari ukuran input maksimum yang diizinkan model).
- max_length (
int, opsional) — Mengontrol panjang maksimum yang digunakan oleh salah satu parameter truncation/padding.Jika tidak disetel atau disetel ke
None, ini akan menggunakan panjang maksimum model yang telah didefinisikan sebelumnya jika panjang maksimum diperlukan oleh salah satu parameter truncation/padding. Jika model tidak memiliki panjang input maksimum yang spesifik (seperti XLNet), truncation/padding ke panjang maksimum akan dinonaktifkan. - stride (
int, opsional, default 0) — Jika diatur ke sebuah angka bersama denganmax_length, token yang meluap yang dikembalikan saatreturn_overflowing_tokens=Trueakan berisi beberapa token dari akhir urutan terpotong yang dikembalikan untuk menyediakan beberapa tumpang tindih antara urutan terpotong dan urutan yang meluap. Nilai argumen ini menentukan jumlah token yang tumpang tindih. - is_split_into_words (
bool, opsional, defaultFalse) — Apakah input sudah di-pre-tokenisasi (misalnya, dipecah menjadi kata). Jika disetel keTrue, tokenizer mengasumsikan input sudah dipecah menjadi kata (misalnya, dengan memisahkannya berdasarkan spasi) yang akan ditokenisasi. Ini berguna untuk NER atau klasifikasi token. - pad_to_multiple_of (
int, opsional) — Jika diset, akan melakukanpaddingpada urutan hingga menjadi kelipatan dari nilai yang diberikan. Memerlukanpaddinguntuk diaktifkan. Ini sangat berguna untuk memungkinkan penggunaan Tensor Cores pada perangkat keras NVIDIA dengan kemampuan komputasi>= 7.5(Volta). - padding_side (
str, opsional) — Sisi tempat model harus menerapkan padding. Harus dipilih antara [‘right’, ‘left’]. Nilai default diambil dari atribut kelas dengan nama yang sama. - return_tensors (
stratau TensorType, opsional) — Jika diset, akan mengembalikan tensor alih-alih daftar integer Python. Nilai yang dapat diterima adalah:'pt': Mengembalikan objek PyTorchtorch.Tensor.'np': Mengembalikan objek Numpynp.ndarray.
- return_token_type_ids (
bool, opsional) — Apakah akan mengembalikan token type ID. Jika dibiarkan pada nilai default, akan mengembalikan token type ID sesuai dengan default tokenizer tertentu, yang ditentukan olehreturn_outputsatribut. - return_attention_mask (
bool, opsional) — Apakah akan mengembalikan attention mask. Jika dibiarkan pada nilai default, akan mengembalikan attention mask sesuai dengan default tokenizer tertentu, yang didefinisikan olehreturn_outputsatribut. - return_overflowing_tokens (
bool, opsional, defaultFalse) — Apakah akan mengembalikan urutan token yang meluap. Jika sepasang urutan id input (atau batch dari pasangan) diberikan dengantruncation_strategy = longest_firstatauTrue, error akan dilemparkan alih-alih mengembalikan token yang meluap. - return_special_tokens_mask (
bool, opsional, defaultFalse) — Apakah akan mengembalikan informasi mask token khusus. - return_offsets_mapping (
bool, opsional, defaultnyaFalse) — Apakah akan mengembalikan(char_start, char_end)untuk setiap token.Ini hanya tersedia pada fast tokenizer yang mewarisi dari PreTrainedTokenizerFast, jika menggunakan tokenizer Python, metode ini akan memicu
NotImplementedError. - return_length (
bool, opsional, defaultFalse) — Apakah akan mengembalikan panjang dari input yang dikodekan. - verbose (
bool, opsional, defaultnyaTrue) — Apakah akan mencetak lebih banyak informasi dan peringatan. - **kwargs — diteruskan ke metode
self.tokenize()
Mengembalikan
BatchEncoding dengan bidang berikut:
-
input_ids — Daftar id token yang akan diberikan ke model.
-
token_type_ids — Daftar token type id yang akan diberikan ke model (ketika
return_token_type_ids=Trueatau jika “token_type_ids” ada diself.model_input_names). -
attention_mask — Daftar indeks yang menentukan token mana yang harus diperhatikan oleh model (ketika
return_attention_mask=Trueatau jika “attention_mask” ada diself.model_input_names). -
overflowing_tokens — Daftar sekuens token yang meluap (ketika
max_lengthditentukan danreturn_overflowing_tokens=True). -
num_truncated_tokens — Jumlah token yang dipangkas (ketika
max_lengthditentukan danreturn_overflowing_tokens=True). -
special_tokens_mask — Daftar angka 0 dan 1, di mana 1 menandakan token khusus yang ditambahkan dan 0 menandakan token urutan reguler (ketika
add_special_tokens=Truedanreturn_special_tokens_mask=True). -
length — Panjang dari input (ketika
return_length=True)
Metode utama untuk melakukan tokenisasi dan persiapan satu atau beberapa urutan atau satu atau beberapa pasangan urutan untuk model.
save_vocabulary
< source >( save_directory: strfilename_prefix: str | None = None ) → Tuple(str)
Simpan file kosakata dan token khusus ke sebuah direktori.
batch_decode
< source >( sequences: list[int] | list[list[int]] | np.ndarray | torch.Tensorskip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = None**kwargs ) → list[str]
Parameter
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — Daftar id input yang telah ditokenisasi. Dapat diperoleh menggunakan metode__call__. - skip_special_tokens (
bool, opsional, defaultnyaFalse) — Apakah token khusus akan dihapus saat decoding. - clean_up_tokenization_spaces (
bool, opsional) — Apakah akan membersihkan spasi tokenisasi. JikaNone, akan menggunakan nilai defaultself.clean_up_tokenization_spaces. - kwargs (argumen kata kunci tambahan, opsional) — Akan diteruskan ke metode decode spesifik model yang mendasarinya.
Mengembalikan
list[str]
Daftar kalimat yang telah didekode.
Konversi daftar dari daftar id token menjadi daftar string dengan memanggil decode.
Metode ini disediakan untuk kompatibilitas mundur. Metode decode sekarang menangani input batch secara native,
sehingga Anda dapat menggunakan decode secara langsung alih-alih batch_decode.
FastSpeech2ConformerModel
kelas transformers.FastSpeech2ConformerModel
< source >( config: FastSpeech2ConformerConfig )
Parameter
- config (FastSpeech2ConformerConfig) — Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode from_pretrained() untuk memuat bobot model.
Model FastSpeech2Conformer.
Model ini mewarisi dari PreTrainedModel. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran embedding input, memangkas kepala, dll.)
Model ini juga merupakan subclass dari torch.nn.Module PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
Parameter
- input_ids (
torch.LongTensordengan bentuk(batch_size, sequence_length)) — Urutan input dari vektor teks. - attention_mask (
torch.LongTensordengan bentuk(batch_size, sequence_length), opsional) — Mask untuk menghindari eksekusi attention pada indeks token padding. Nilai mask dipilih dari[0, 1]:- 1 untuk token yang tidak dimasker,
- 0 untuk token yang dimasker.
- spectrogram_labels (
torch.Tensordengan bentuk(batch_size, max_spectrogram_length, num_mel_bins), opsional, defaultNone) — Batch dari fitur target yang di-pad. - duration_labels (
torch.LongTensordengan bentuk(batch_size, sequence_length + 1), opsional, defaultnyaNone) — Batch durasi yang di-pad. - pitch_labels (
torch.Tensordengan bentuk(batch_size, sequence_length + 1, 1), opsional, defaultNone) — Batch dari pitch rata-rata token yang di-pad. - energy_labels (
torch.Tensordengan bentuk(batch_size, sequence_length + 1, 1), opsional, defaultNone) — Batch dari energi rata-rata token yang telah di-pad. - speaker_ids (
torch.LongTensordengan bentuk(batch_size, 1), opsional, defaultNone) — ID pembicara yang digunakan untuk mengondisikan fitur output ucapan oleh model. - lang_ids (
torch.LongTensordengan bentuk(batch_size, 1), opsional, defaultNone) — ID bahasa yang digunakan untuk mengondisikan fitur output ucapan oleh model. - speaker_embedding (
torch.Tensordengan bentuk(batch_size, embedding_dim), opsional, defaultNone) — Embedding yang berisi sinyal kondisioning untuk fitur ucapan. - return_dict (
bool, opsional) — Apakah akan mengembalikan ModelOutput alih-alih tuple biasa. - output_attentions (
bool, opsional) — Apakah akan mengembalikan tensor attentions dari semua lapisan attention. Lihatattentionsdi bawah tensor yang dikembalikan untuk detail lebih lanjut. - output_hidden_states (
bool, opsional) — Apakah akan mengembalikan hidden states dari semua lapisan. Lihathidden_statesdi bawah tensor yang dikembalikan untuk detail lebih lanjut.
Mengembalikan
FastSpeech2ConformerModelOutput atau tuple(torch.Tensor)
FastSpeech2ConformerModelOutput atau tuple dari
torch.Tensor (jika return_dict=False diteruskan atau ketika config.return_dict=False) yang terdiri dari berbagai
elemen tergantung pada konfigurasi (FastSpeech2ConformerConfig) dan input.
Metode forward dari FastSpeech2ConformerModel menimpa metode khusus __call__.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance
Modulesetelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
loss (
torch.Tensordengan bentuk(1,), opsional, dikembalikan saatlabelsdisediakan) — Loss generasi spektrogram.spectrogram (
torch.Tensordengan bentuk(batch_size, sequence_length, num_bins), opsional) — Spektrogram yang diprediksi.encoder_last_hidden_state (
torch.Tensordengan bentuk(batch_size, sequence_length, hidden_size), opsional) — Urutan hidden-states pada keluaran lapisan terakhir dari encoder model.encoder_hidden_states (
tuple[torch.Tensor], opsional, dikembalikan ketikaoutput_hidden_states=Truedilewatkan atau ketikaconfig.output_hidden_states=True) — Tuple daritorch.Tensor(satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk(batch_size, sequence_length, hidden_size).Hidden-states dari encoder pada output setiap layer ditambah output embedding awal.
encoder_attentions (
tuple[torch.Tensor], opsional, dikembalikan saatoutput_attentions=Truedilewatkan atau saatconfig.output_attentions=True) — Tuple daritorch.Tensor(satu untuk setiap layer) dengan bentuk(batch_size, num_heads, sequence_length, sequence_length).Bobot perhatian dari encoder, setelah softmax perhatian, yang digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
decoder_hidden_states (
tuple[torch.Tensor], opsional, dikembalikan saatoutput_hidden_states=Truedilewatkan atau saatconfig.output_hidden_states=True) — Tuple daritorch.Tensor(satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk(batch_size, sequence_length, hidden_size).Hidden-states dari decoder pada output setiap layer ditambah output embedding awal.
decoder_attentions (
tuple[torch.Tensor], opsional, dikembalikan ketikaoutput_attentions=Truedilewatkan atau ketikaconfig.output_attentions=True) — Tuple daritorch.Tensor(satu untuk setiap lapisan) dengan bentuk(batch_size, num_heads, sequence_length, sequence_length).Bobot perhatian dari decoder, setelah softmax perhatian, yang digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
duration_outputs (
torch.LongTensordengan bentuk(batch_size, max_text_length + 1), opsional) — Output dari duration predictor.pitch_outputs (
torch.Tensordengan bentuk(batch_size, max_text_length + 1, 1), opsional) — Output dari prediktor pitch.energy_outputs (
torch.Tensordengan bentuk(batch_size, max_text_length + 1, 1), opsional) — Output dari prediktor energi.
Contoh:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerModel,
...     FastSpeech2ConformerHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer")
>>> output_dict = model(input_ids, return_dict=True)
>>> spectrogram = output_dict["spectrogram"]

>>> vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
>>> waveform = vocoder(spectrogram)
>>> print(waveform.shape)
torch.Size([1, 49664])
FastSpeech2ConformerHifiGan
kelas transformers.FastSpeech2ConformerHifiGan
< source >( config: FastSpeech2ConformerHifiGanConfig )
Parameter
- config (FastSpeech2ConformerHifiGanConfig) — Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode from_pretrained() untuk memuat bobot model.
Vocoder HiFi-GAN.
Model ini mewarisi dari PreTrainedModel. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran embedding input, memangkas kepala, dll.)
Model ini juga merupakan subclass dari torch.nn.Module PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
forward
< source >( spectrogram: Tensor**kwargs ) → torch.Tensor
Parameter
- spectrogram (
torch.Tensor) — Tensor yang berisi log-mel spectrograms. Dapat di-batch dengan bentuk(batch_size, sequence_length, config.model_in_dim), atau tanpa batch dengan bentuk(sequence_length, config.model_in_dim).
Mengembalikan
torch.Tensor
Tensor yang berisi waveform ucapan. Jika input spectrogram di-batch, bentuknya akan menjadi (batch_size, num_frames,). Jika tidak di-batch, bentuknya akan menjadi (num_frames,).
Mengonversi log-mel spectrogram menjadi waveform ucapan. Menyerahkan batch log-mel spectrogram mengembalikan batch waveform ucapan. Menyerahkan log-mel spectrogram tunggal, tanpa batch, mengembalikan waveform ucapan tunggal, tanpa batch.
FastSpeech2ConformerWithHifiGan
kelas transformers.FastSpeech2ConformerWithHifiGan
< source >( config: FastSpeech2ConformerWithHifiGanConfig )
Parameter
- config (FastSpeech2ConformerWithHifiGanConfig) — Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode from_pretrained() untuk memuat bobot model.
The FastSpeech2ConformerModel dengan kepala vocoder FastSpeech2ConformerHifiGan yang melakukan text-to-speech (waveform).
Model ini mewarisi dari PreTrainedModel. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran embedding input, memangkas kepala, dll.)
Model ini juga merupakan subclass dari torch.nn.Module PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
Parameter
- input_ids (
torch.LongTensordengan bentuk(batch_size, sequence_length)) — Urutan input dari vektor teks. - attention_mask (
torch.LongTensordengan bentuk(batch_size, sequence_length), opsional) — Mask untuk menghindari eksekusi attention pada indeks token padding. Nilai mask dipilih dari[0, 1]:- 1 untuk token yang tidak dimasker,
- 0 untuk token yang dimasker.
- spectrogram_labels (
torch.Tensordengan bentuk(batch_size, max_spectrogram_length, num_mel_bins), opsional, defaultNone) — Batch dari fitur target yang di-pad. - duration_labels (
torch.LongTensordengan bentuk(batch_size, sequence_length + 1), opsional, defaultnyaNone) — Batch durasi yang di-pad. - pitch_labels (
torch.Tensordengan bentuk(batch_size, sequence_length + 1, 1), opsional, defaultNone) — Batch dari pitch rata-rata token yang di-pad. - energy_labels (
torch.Tensordengan bentuk(batch_size, sequence_length + 1, 1), opsional, defaultNone) — Batch dari energi rata-rata token yang telah di-pad. - speaker_ids (
torch.LongTensordengan bentuk(batch_size, 1), opsional, defaultNone) — ID pembicara yang digunakan untuk mengondisikan fitur output ucapan oleh model. - lang_ids (
torch.LongTensordengan bentuk(batch_size, 1), opsional, defaultNone) — ID bahasa yang digunakan untuk mengondisikan fitur output ucapan oleh model. - speaker_embedding (
torch.Tensordengan bentuk(batch_size, embedding_dim), opsional, defaultNone) — Embedding yang berisi sinyal kondisioning untuk fitur ucapan. - return_dict (
bool, opsional) — Apakah akan mengembalikan ModelOutput alih-alih tuple biasa. - output_attentions (
bool, opsional) — Apakah akan mengembalikan tensor attentions dari semua lapisan attention. Lihatattentionsdi bawah tensor yang dikembalikan untuk detail lebih lanjut. - output_hidden_states (
bool, opsional) — Apakah akan mengembalikan hidden states dari semua lapisan. Lihathidden_statesdi bawah tensor yang dikembalikan untuk detail lebih lanjut.
Mengembalikan
FastSpeech2ConformerModelOutput atau tuple(torch.Tensor)
FastSpeech2ConformerModelOutput atau tuple dari
torch.Tensor (jika return_dict=False diteruskan atau ketika config.return_dict=False) yang terdiri dari berbagai
elemen tergantung pada konfigurasi (FastSpeech2ConformerConfig) dan input.
Metode forward dari FastSpeech2ConformerWithHifiGan menimpa metode khusus __call__.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance
Modulesetelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
loss (
torch.Tensordengan bentuk(1,), opsional, dikembalikan saatlabelsdisediakan) — Loss generasi spektrogram.spectrogram (
torch.Tensordengan bentuk(batch_size, sequence_length, num_bins), opsional) — Spektrogram yang diprediksi.encoder_last_hidden_state (
torch.Tensordengan bentuk(batch_size, sequence_length, hidden_size), opsional) — Urutan hidden-states pada keluaran lapisan terakhir dari encoder model.encoder_hidden_states (
tuple[torch.Tensor], opsional, dikembalikan ketikaoutput_hidden_states=Truedilewatkan atau ketikaconfig.output_hidden_states=True) — Tuple daritorch.Tensor(satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk(batch_size, sequence_length, hidden_size).Hidden-states dari encoder pada output setiap layer ditambah output embedding awal.
encoder_attentions (
tuple[torch.Tensor], opsional, dikembalikan saatoutput_attentions=Truedilewatkan atau saatconfig.output_attentions=True) — Tuple daritorch.Tensor(satu untuk setiap layer) dengan bentuk(batch_size, num_heads, sequence_length, sequence_length).Bobot perhatian dari encoder, setelah softmax perhatian, yang digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
decoder_hidden_states (
tuple[torch.Tensor], opsional, dikembalikan saatoutput_hidden_states=Truedilewatkan atau saatconfig.output_hidden_states=True) — Tuple daritorch.Tensor(satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk(batch_size, sequence_length, hidden_size).Hidden-states dari decoder pada output setiap layer ditambah output embedding awal.
decoder_attentions (
tuple[torch.Tensor], opsional, dikembalikan ketikaoutput_attentions=Truedilewatkan atau ketikaconfig.output_attentions=True) — Tuple daritorch.Tensor(satu untuk setiap lapisan) dengan bentuk(batch_size, num_heads, sequence_length, sequence_length).Bobot perhatian dari decoder, setelah softmax perhatian, yang digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
duration_outputs (
torch.LongTensordengan bentuk(batch_size, max_text_length + 1), opsional) — Output dari duration predictor.pitch_outputs (
torch.Tensordengan bentuk(batch_size, max_text_length + 1, 1), opsional) — Output dari prediktor pitch.energy_outputs (
torch.Tensordengan bentuk(batch_size, max_text_length + 1, 1), opsional) — Output dari prediktor energi.
Contoh:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
>>> output_dict = model(input_ids, return_dict=True)
>>> waveform = output_dict["waveform"]
>>> print(waveform.shape)
torch.Size([1, 49664])